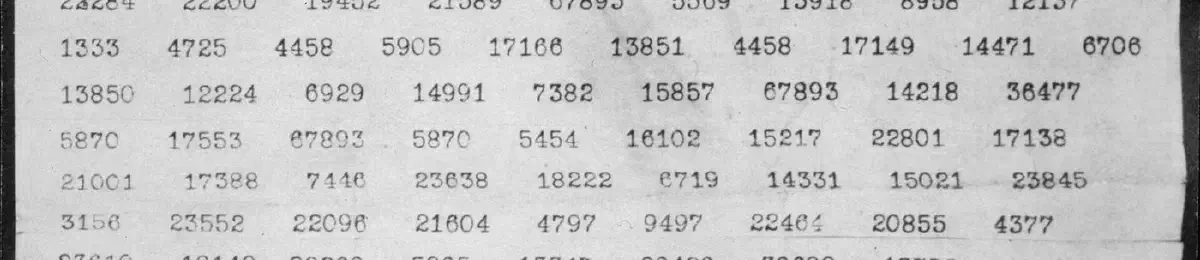
Telegrama Zimmermann tal como lo recibió el embajador alemán en México — Códigos: esconder, comprimir y proteger un mensaje
Legación alemana en México / Western Union, 1917 · Public domain · Wikimedia Commons
Itinerarios / medio

Códigos: esconder, comprimir y proteger un mensaje

Cifrar, comprimir, corregir errores y firmar un mensaje, con una figura por técnica y lo que sirve de cada una al descargar un fichero o guardar una clave.

8 capítulos · 8,274 palabras · 42 min · cada capítulo es un artículo de la enciclopedia

Ocho capítulos sobre lo que se le puede hacer a un mensaje: esconderlo, encogerlo, protegerlo del ruido, firmarlo y resumirlo en una huella. Cada uno tiene una figura para probarlo con las manos, y cada bloque deja algo que sirve al usar un ordenador.

El primer bloque es cifrar. César y Vigenère caen por lo mismo: las letras de una lengua no salen con la misma frecuencia, y eso se nota a través de cualquier sustitución. De ahí salen dos reglas. Un cifrado es seguro solo si saber cómo funciona no sirve de nada sin la clave, así que un método secreto no protege. Y una clave que se repite es una clave que se rompe.

El segundo es comprimir y corregir. Huffman y Lempel-Ziv ahorran bits donde el mensaje es predecible, y juntos son el formato de ZIP, gzip y PNG. Hamming hace lo contrario: añade tres bits por cada cuatro para que un error se corrija solo. Conviene conocer su límite. Con dos errores, el código corrige el bit equivocado y entrega un mensaje falso con toda confianza, y por eso la memoria de los servidores añade un bit más, que detecta el segundo error y pide repetir.

El tercero es la seguridad de todos los días. El candado del navegador es una cadena de firmas. La clave pública sirve para acordar un secreto y para firmar, y el tráfico viaja cifrado con una clave simétrica, que es más rápida. La huella SHA-256 sirve para comprobar que un fichero descargado es el que se publicó; MD5 y SHA-1 ya no valen para eso. Y las contraseñas no se guardan con SHA-256 sin más, porque es demasiado rápida: se guardan con sal y con funciones lentas a propósito, como bcrypt o Argon2.

Los dos últimos capítulos son de eficiencia. La tabla hash encuentra algo por su nombre sin mirar el resto, a cambio de perder el orden. El filtro de Bloom responde «seguro que no» o «quizá». Si dice que no, uno se ahorra una consulta cara; si dice quizá, hay que comprobar.

Si solo hay tiempo para dos capítulos, la clave pública y la función hash.

Capítulo 1 de 8

El cifrado de César y el de Vigenère

Informática 970 palabras artículo suelto ↗

El cifrado de César (en inglés, Caesar cipher) sustituye cada letra de un mensaje por la que está un número fijo de puestos más adelante en el alfabeto, y el cifrado de Vigenère (Vigenère cipher) hace lo mismo pero cambiando el desplazamiento letra a letra según una palabra clave (keyword). El primero lo usaba Julio César para su correspondencia, según cuenta Suetonio, con un desplazamiento de tres; el segundo se consideró irrompible durante trescientos años y lo llamaron le chiffre indéchiffrable. Los dos caen ante la misma arma, la estadística de la lengua, y la manera en que caen es la primera lección de la criptografía: un cifrado no es seguro porque nadie sepa cómo funciona, sino porque saberlo no sirve de nada sin la clave.

Página del tratado de al-Kindi sobre el descifrado de mensajes (siglo IX), el texto más antiguo que se conoce sobre criptoanálisis. Explica que en cada lengua unas letras aparecen más que otras, y que basta contarlas en el texto cifrado para reconocer cuáles son. Se redescubrió en los archivos otomanos de Estambul en 1987.
Fig. 1 Página del tratado de al-Kindi sobre el descifrado de mensajes (siglo IX), el texto más antiguo que se conoce sobre criptoanálisis. Explica que en cada lengua unas letras aparecen más que otras, y que basta contarlas en el texto cifrado para reconocer cuáles son. Se redescubrió en los archivos otomanos de Estambul en 1987.Al-Kindi (manuscrito) · Dominio público · Wikimedia Commons

El cifrado de César es fácil de romper por dos motivos, y la figura muestra los dos. El primero es que solo hay veinticinco claves posibles —veinticinco desplazamientos distintos—, así que se pueden probar todas y quedarse con la que produce castellano. El segundo es más profundo y sobrevive a los cifrados con muchas más claves: el desplazamiento no cambia la forma del texto, solo la etiqueta de cada letra. En español, la E es el 13,7 % de las letras, la A el 12,5 %, la O el 8,7 %, y así hasta la W, que no llega al 0,01 %. Un texto cifrado (ciphertext) con César tiene las mismas proporciones con los nombres cambiados: la letra más frecuente del criptograma es, casi seguro, la E, y la distancia entre ambas es la clave. El histograma de la figura lo hace ver a simple vista: las barras del texto cifrado son las del español, corridas. El filósofo y matemático árabe al-Kindi lo explicó en el siglo IX en un tratado que se dio por perdido hasta 1987, y su método, el análisis de frecuencias (frequency analysis), es la razón de que todos los cifrados por sustitución simple —incluidos los que usan un alfabeto desordenado, con 26! claves posibles, un número de veintisiete cifras— se rompan con un lápiz y una tarde.

Interactivo Un texto en claro, su versión cifrada y la estadística que lo delata. Con César, las barras del texto cifrado son las frecuencias del español corridas tantos puestos como la clave, y la gráfica de la derecha mide cuánto desencaja cada desplazamiento posible. Con Vigenère el histograma se aplana, pero al partir el texto en columnas según la longitud probable de la clave, el índice de coincidencia de la derecha vuelve a delatar el español. «Romper sin la clave» hace las dos cosas solo.

La respuesta a al-Kindi tardó seiscientos años y fue el cifrado polialfabético: usar no un alfabeto de sustitución sino varios, y cambiar de uno a otro con cada letra. Leon Battista Alberti lo propuso en 1467 con un disco de dos coronas giratorias; Johannes Trithemius lo sistematizó en 1508 en una tabla cuadrada con los veintiséis alfabetos desplazados; Giovan Battista Bellaso publicó en 1553 la idea de elegir el alfabeto de cada letra con una palabra clave que se repite, que es lo que hoy se llama cifrado de Vigenère; y Blaise de Vigenère, diplomático francés, lo describió en su Traicté des chiffres de 1586 junto con una variante más fuerte que sí era suya, en la que la clave es el propio mensaje. El nombre se le quedó por error de los historiadores del siglo XIX. El efecto se ve al pulsar el botón de la figura: con la clave «QUIJOTE», la A del texto sale unas veces como Q, otras como U, otras como I, y el histograma del criptograma se aplana. Contar letras ya no delata a nadie. Durante tres siglos se creyó que eso bastaba.

Blaise de Vigenère (1523-1596), grabado por Léonard Gaultier. Diplomático al servicio del duque de Nevers y del rey de Francia, describió en 1586 el cifrado que lleva su nombre, que en realidad había publicado Bellaso en 1553, y otro más fuerte que sí era suyo, que nadie recuerda.
Fig. 3 Blaise de Vigenère (1523-1596), grabado por Léonard Gaultier. Diplomático al servicio del duque de Nevers y del rey de Francia, describió en 1586 el cifrado que lleva su nombre, que en realidad había publicado Bellaso en 1553, y otro más fuerte que sí era suyo, que nadie recuerda.Léonard Gaultier · 1595 · Dominio público · Wikimedia Commons

No bastaba, y la razón está en la palabra que se repite. Si la clave tiene siete letras, las letras del mensaje que ocupan las posiciones 1, 8, 15, 22… se han cifrado todas con la misma letra de la clave, es decir, con el mismo César. Basta con adivinar la longitud de la clave, separar el criptograma en siete columnas y romper cada columna por frecuencias como si fuera César. Charles Babbage lo consiguió hacia 1854 y no lo publicó, quizá por interés militar en plena guerra de Crimea; el oficial prusiano Friedrich Kasiski lo publicó en 1863, con un método para averiguar la longitud —buscar trozos repetidos en el criptograma, que suelen estar a una distancia múltiplo de la longitud de la clave— y con ello el cifrado indescifrable dejó de serlo. La figura usa una herramienta posterior, más elegante, la que William Friedman propuso en 1922 y con la que empezó la criptografía matemática: el índice de coincidencia, la probabilidad de que dos letras tomadas al azar de un texto sean iguales. En un texto en español vale 0,077, porque las letras frecuentes coinciden mucho; en un texto en el que todas las letras fueran igual de probables valdría 1/26, 0,038. Un criptograma de Vigenère, bien mezclado, se acerca a 0,04; pero si se parte en columnas con la longitud correcta, cada columna es un César del español y su índice vuelve a 0,077. Las barras de la derecha de la figura calculan el índice para longitudes de 1 a 12: la longitud verdadera sobresale, y el botón «Romper» la usa para recuperar la clave letra a letra.

La única variante que resiste es la que Vigenère intuyó y Gilbert Vernam patentó en 1917: una clave tan larga como el mensaje, aleatoria y usada una sola vez. Con ella no hay columnas que separar, cada letra del criptograma es igual de probable que cualquier otra y Claude Shannon demostró en 1949 que el criptograma no contiene ninguna información sobre el mensaje. La libreta de un solo uso (one-time pad) es perfectamente segura y perfectamente impráctica, porque la clave hay que hacerla llegar al destinatario por un canal tan seguro como el que se quería proteger, y ese problema —cómo compartir un secreto con alguien a quien no se puede ver— es el que resuelve la clave pública. Entre medias quedan las dos lecciones de la figura: que la estructura de la lengua se filtra a través de cualquier sustitución, y que una clave que se repite es una clave que se rompe.

Capítulo 2 de 8

La codificación de Huffman

Informática 1077 palabras artículo suelto ↗

La codificación de Huffman (en inglés, Huffman coding) es el método para escribir un texto con el menor número de bits posible dando a cada símbolo un código de longitud fija para ese símbolo: cortos para los símbolos frecuentes, largos para los raros. David Huffman la inventó en 1951 siendo estudiante de doctorado en el MIT, para librarse de un examen final, y demostró que ningún otro código de ese tipo puede ser más corto. Es la pieza final de casi todos los compresores que se usan hoy —ZIP, gzip, PNG, JPEG, MP3— y la manera más clara de ver una idea que Claude Shannon había demostrado tres años antes: que la información de un mensaje se mide en la sorpresa de sus símbolos, y que la compresión (compression) consiste en gastar bits donde hay sorpresa y ahorrarlos donde no.

El código Morse internacional en la tabla de Snodgrass y Camp (1922). Morse y Vail asignaron en 1838 los signos más cortos a las letras más frecuentes del inglés —un punto para la E, una raya para la T— tras contar los tipos de imprenta de un periódico: el mismo principio que Huffman llevaría al óptimo un siglo después.
Fig. 1 El código Morse internacional en la tabla de Snodgrass y Camp (1922). Morse y Vail asignaron en 1838 los signos más cortos a las letras más frecuentes del inglés —un punto para la E, una raya para la T— tras contar los tipos de imprenta de un periódico: el mismo principio que Huffman llevaría al óptimo un siglo después.Rhey T. Snodgrass y Victor F. Camp · 1922 · Dominio público · Wikimedia Commons

La idea de dar signos cortos a lo frecuente es anterior a la teoría. Samuel Morse y Alfred Vail, al diseñar su código en 1838, fueron a una imprenta de Morristown y contaron cuántos tipos de cada letra tenía el cajista: había doce mil de la E y solo doscientos de la Z. A la E le dieron un punto; a la Z, dos rayas y dos puntos. El código Morse (Morse code) no es óptimo —los operadores necesitaban pausas entre letras, que son un tercer símbolo escondido— pero encierra la intuición correcta. Lo que faltaba era la teoría de a cuánto se puede aspirar y el procedimiento para conseguirlo.

La teoría la puso Shannon en 1948. La cantidad de información de un símbolo es el logaritmo del inverso de su probabilidad: un símbolo que aparece la mitad de las veces aporta un bit, uno que aparece una de cada mil veces aporta casi diez. La media de esa cantidad sobre todos los símbolos, ponderada por su frecuencia, es la entropía (entropy) de la fuente, y Shannon demostró que es el número medio de bits por símbolo por debajo del cual ningún código sin pérdidas puede bajar, y al que se puede acercar tanto como se quiera. Para un texto en castellano, contando letras sueltas, la entropía ronda los cuatro bits por letra, frente a los cinco que hacen falta para numerar veintisiete letras y a los ocho de ASCII. Shannon dio también un código que se acercaba al límite, con Robert Fano, pero no era el mejor posible, y Fano puso a sus estudiantes del MIT a buscar el óptimo como trabajo de curso, ofreciendo librar del examen a quien lo encontrara. Él mismo no sabía si existía.

Interactivo El algoritmo de Huffman sobre el texto de la caja, que se puede cambiar. Cada letra empieza como un árbol de un solo nodo con su número de apariciones; en cada paso se funden los dos árboles más ligeros bajo un nodo nuevo que pesa la suma. El código de cada letra es el camino desde la raíz: 0 a la izquierda, 1 a la derecha. La tabla cuenta los bits y los compara con un código de longitud fija y con el límite de Shannon.

Huffman lo encontró en el otoño de 1951, después de meses de intentos fallidos y, según contó cuarenta años después, justo cuando había decidido tirar los apuntes y estudiar para el examen. La solución consiste en construir el código al revés de como lo habían intentado todos: en lugar de repartir los bits de arriba abajo, empezando por separar los símbolos en dos grupos de peso parecido, se empieza por abajo, por los dos símbolos menos frecuentes. Se cuentan las apariciones de cada símbolo. Se toman los dos con menos apariciones y se unen bajo un nodo nuevo cuyo peso es la suma de los dos. Se repite con el bosque resultante —el nodo nuevo compite con los demás como si fuera un símbolo más— hasta que solo queda un árbol (tree). El código de cada símbolo es el camino desde la raíz hasta su hoja, con un cero por cada rama izquierda y un uno por cada derecha. La figura hace las fusiones una a una: los símbolos raros se funden primero y por eso acaban en lo más profundo, con códigos largos; los frecuentes se quedan cerca de la raíz.

El procedimiento tiene dos propiedades que lo hacen funcionar. La primera es que ningún código es prefijo de otro: como todos los símbolos son hojas, al leer bits de uno en uno se sabe con certeza dónde acaba cada símbolo sin necesidad de separadores, que era la pausa que le sobraba al Morse. La segunda es la optimalidad, que Huffman demostró en dos páginas de 1952: en cualquier código óptimo los dos símbolos menos frecuentes tienen la misma longitud y difieren solo en el último bit, así que se pueden tratar como uno solo sin perder nada, y el argumento se repite hacia arriba. El código resultante gasta, de media, menos de un bit por símbolo por encima de la entropía, y la figura permite comprobarlo con cualquier texto: para la frase inicial del Quijote, alrededor de cuatro bits por carácter frente a los cinco del código fijo y los ocho de ASCII, con la entropía a pocas centésimas por debajo.

Ese bit de más es la limitación del método, y de él salieron los que le siguieron. Huffman asigna a cada símbolo un número entero de bits, y un símbolo con probabilidad 0,9 —que debería costar 0,15 bits— cuesta uno entero; la codificación aritmética de los años setenta y ochenta esquiva el problema codificando el mensaje completo como un único número, y se acerca a la entropía tanto como se quiera. Y Huffman mira los símbolos de uno en uno, cuando en un texto real la información está en las secuencias: después de una Q viene una U casi seguro. Jacob Ziv y Abraham Lempel publicaron en 1977 el algoritmo que sustituye las repeticiones por referencias a lo ya visto, y la combinación de los dos métodos —Lempel-Ziv para las repeticiones, Huffman para lo que queda— es el formato deflate de ZIP, gzip y PNG, que desde 1993 comprime buena parte de lo que circula por internet. En JPEG y MP3 el trabajo duro lo hace la parte con pérdidas, que decide qué no se verá ni se oirá, y Huffman remata empaquetando lo que sobrevive.

La figura pide poco y da mucho a cambio, y eso resume por qué el método ha durado setenta años: es exacto, es rápido, es óptimo en su clase y se explica con un dibujo. Lo que Huffman inventó para no examinarse describe algo que hacen las lenguas por su cuenta —las palabras más frecuentes son las más cortas, como muestra la ley de Zipf— y que el código Morse ya intuía: la eficiencia consiste en no gastar en lo esperado. El siguiente artículo, sobre el código de Hamming, hace lo contrario a propósito: añade bits que sobran para que el mensaje sobreviva a los errores.

La compresión de Lempel-Ziv – El montículo binario

Capítulo 3 de 8

La compresión de Lempel-Ziv

Informática 1063 palabras artículo suelto ↗

La compresión de Lempel-Ziv (en inglés, Lempel-Ziv compression) es una familia de métodos para reducir el tamaño de un texto, o de cualquier fichero, sustituyendo cada fragmento que ya ha aparecido antes por una referencia a su aparición anterior. En lugar de escribir otra vez «tristes tigres», el compresor (compressor) anota algo como «copia catorce caracteres empezando treinta y un caracteres atrás». Si la referencia ocupa menos que el fragmento, el fichero encoge. Abraham Lempel y Jacob Ziv, dos ingenieros del Technion de Haifa, publicaron la idea en 1977, y casi medio siglo después sigue dentro de los ficheros ZIP, de las imágenes PNG, de los programas que se descargan y de buena parte de las páginas web, que viajan por la red comprimidas con una variante suya.

La figura de esta página comprime un texto delante del lector. Cada tramo sombreado en naranja no se guarda letra a letra sino como una referencia hacia atrás, y al pasar el puntero por encima se ilumina en negro el tramo del que se copia. Lo que queda sin sombrear son letras sueltas, que se guardan tal cual. Las dos barras de abajo comparan el tamaño original con el comprimido, calculado con una cuenta sencilla: un bit para distinguir letra de referencia, ocho bits por letra suelta, y para cada referencia los bits necesarios para decir cuánto hay que retroceder y ocho más para decir cuánto hay que copiar. El texto se puede cambiar, y el menú trae cinco ejemplos elegidos para que salgan cosas distintas.

Interactivo Los tramos en naranja son referencias a algo ya escrito: pasa el puntero por uno y se ilumina el original. Cambia el texto o elige otro del menú, y prueba ventanas de distinto tamaño. Las barras comparan el texto original con el comprimido, contando un bit por pieza más ocho por letra suelta, o los bits de la distancia y la longitud por referencia.

El trabalenguas de los tigres se reduce a menos de la mitad, porque el ochenta por ciento de sus letras repite algo que ya había salido. El primer párrafo del Quijote encoge bastante menos: la mitad de sus caracteres se pueden copiar de atrás, pero en trozos cortos, como «de la», « los » o «que », y cada referencia cuesta casi lo mismo que las tres o cuatro letras que ahorra. La cadena «abababab» enseña el caso extremo y un detalle ingenioso del método: después de las dos primeras letras, una sola referencia dice «copia doscientos treinta y ocho caracteres empezando dos atrás». La copia se solapa consigo misma, porque se hace carácter a carácter y cada letra copiada ya está disponible para la siguiente, así que una referencia puede repetir un patrón tantas veces como haga falta. Las letras al azar, en cambio, no tienen nada que repetir, y el resultado ocupa más que el original.

Ese último caso no es un defecto del algoritmo sino un teorema. Ningún método sin pérdida (lossless) puede encoger todos los ficheros, por una cuenta de casillas: hay más ficheros de mil bits que ficheros de menos de mil bits, así que si un compresor acortara todos, dos ficheros distintos acabarían en el mismo resultado y no se podría saber cuál era el original. Comprimir es apostar a que los datos tienen una estructura, y la de Lempel-Ziv es la repetición: palabras, frases, etiquetas de una página web, filas parecidas en una tabla. La codificación de Huffman apuesta por otra, que unos símbolos sean más frecuentes que otros, y por eso gana con el ADN al azar del menú: cada una de sus cuatro letras cabe en dos bits, la cuarta parte de lo que ocupa, mientras que Lempel-Ziv, que en él solo encuentra repeticiones cortas, no baja del sesenta por ciento.

El tamaño de la ventana, el tramo de texto anterior donde se buscan coincidencias, es el principal ajuste del método. Con una ventana de dieciséis caracteres casi nada se repite tan cerca; con una de 32.768, el máximo del formato DEFLATE que usan ZIP y PNG, se encuentran coincidencias lejanas, pero cada referencia necesita quince bits para decir la distancia. En un texto corto como los de la figura, las ventanas grandes cuestan más de lo que encuentran; en un fichero de megabytes, donde un nombre o una etiqueta se repiten a miles de caracteres de distancia, compensan de sobra. Los compresores reales afinan además la cuenta: no gastan ocho bits fijos en cada letra ni la misma cantidad en cada distancia, sino que pasan las letras y las referencias por una codificación de Huffman, de modo que lo frecuente ocupa poco. Con esa segunda etapa, el párrafo del Quijote se queda en algo menos del sesenta por ciento de su tamaño.

La aportación de Lempel y Ziv no fue solo un procedimiento práctico sino una demostración. Sus dos artículos, el de 1977, que usa la ventana deslizante (sliding window) de la figura, y el de 1978, que va construyendo un diccionario (dictionary) de frases ya vistas, probaron que el método es universal: aplicado a un texto suficientemente largo, comprime tanto como el mejor método diseñado a propósito para esa fuente, sin saber nada de antemano sobre ella. Huffman necesita conocer las frecuencias de los símbolos antes de empezar; Lempel-Ziv las descubre sobre la marcha. En 1984, Terry Welch, de la empresa Sperry, publicó una versión del método de 1978 sencilla y rápida, conocida como LZW, que se convirtió en la orden compress de Unix y en el formato de imagen GIF.

LZW tuvo una historia judicial. Welch había patentado el método, y en 1994 Unisys, la empresa que heredó la patente, empezó a exigir licencias a los programas que creaban imágenes GIF. La respuesta fue un formato nuevo y libre de patentes, PNG, que se basó en DEFLATE, la combinación de la ventana de 1977 con la codificación de Huffman que Phil Katz había creado para el compresor PKZIP y que L. Peter Deutsch documentó en 1996 como norma de internet. La patente expiró en 2003, pero para entonces DEFLATE estaba en todas partes: en los ficheros ZIP y en los .gz, en las imágenes PNG, en los documentos PDF y en la compresión con que los servidores web envían sus páginas.

Los compresores más recientes, como Brotli, que Google publicó en 2015, o Zstandard, que Facebook liberó en 2016, comprimen más, o más deprisa, con ventanas de megabytes y diccionarios preparados de antemano, pero por dentro hacen lo mismo que la figura. Buscan en lo ya escrito el tramo más largo que coincide con lo que viene, y en lugar de repetirlo, apuntan hacia él. La idea tiene algo de lectura: un texto comprimido es un texto que recuerda lo que ya ha dicho.

Capítulo 4 de 8

El código de Hamming

Informática 1093 palabras artículo suelto ↗

El código de Hamming (en inglés, Hamming code) es la manera de enviar un mensaje de forma que, si un bit se estropea por el camino, el receptor no solo se dé cuenta sino que sepa cuál fue y lo repare, sin pedir que se repita nada. Lo consigue añadiendo unos pocos bits redundantes (redundant bits) calculados con una astucia: a un mensaje de cuatro bits le bastan tres de comprobación, siete en total, para localizar cualquier error único entre los siete. Richard Hamming lo inventó en 1947 en los Laboratorios Bell por un motivo muy concreto —una máquina que tiraba su trabajo de fin de semana a la basura— y con ello fundó la teoría de los códigos correctores, que hoy está en cada disco duro, cada módulo de memoria, cada llamada de móvil y cada foto enviada desde una sonda espacial.

Una operadora del censo de Estados Unidos perfora tarjetas hacia 1940. Los ordenadores de relés de los Laboratorios Bell leían datos de tarjetas y cinta perforadas, y un agujero mal leído bastaba para arruinar un cálculo; el código de Hamming nació para que la máquina siguiera trabajando sin nadie que vigilara.
Fig. 1 Una operadora del censo de Estados Unidos perfora tarjetas hacia 1940. Los ordenadores de relés de los Laboratorios Bell leían datos de tarjetas y cinta perforadas, y un agujero mal leído bastaba para arruinar un cálculo; el código de Hamming nació para que la máquina siguiera trabajando sin nadie que vigilara.Autoría desconocida (Archivos Nacionales de EE. UU.) · 1940 · Dominio público · Wikimedia Commons

La historia la contó el propio Hamming muchas veces. En los Laboratorios Bell, los cálculos se hacían en máquinas de relés que leían tarjetas perforadas, y los investigadores como él, sin prioridad, tenían las máquinas los fines de semana. La máquina detectaba los errores —ya usaba un bit de paridad, que avisa cuando el número de unos de una palabra no es el esperado— pero al detectar uno se limitaba a abandonar el trabajo y pasar al siguiente. Dos fines de semana seguidos Hamming encontró el lunes que su cálculo se había interrumpido en la primera hora. «Si la máquina puede saber que hay un error, ¿por qué no puede saber dónde está y arreglarlo?», se preguntó, y la respuesta le ocupó los dos años siguientes. El artículo salió en 1950, con retraso porque Bell quiso patentarlo primero.

Interactivo El código de Hamming (7,4): cuatro bits de datos, tres de paridad, cada uno en una posición que es potencia de dos y vigilando las posiciones cuyo número binario tiene un 1 en su lugar. Pulsa cualquier bit para estropearlo en el camino: las comprobaciones que fallan, leídas como número binario, señalan la posición del error. Con dos errores el código (7,4) se equivoca; el octavo bit del código (8,4) los detecta. El botón de abajo envía dos mil mensajes por un canal con ruido y cuenta cuántos llegan mal con y sin código.

El truco está en dónde se colocan los bits de comprobación, y la figura lo hace visible. Se numeran las siete posiciones del 1 al 7. Los bits de paridad (parity bits) van en las posiciones que son potencias de dos, la 1, la 2 y la 4; los cuatro bits de datos, en las demás. El primer bit de paridad vigila todas las posiciones cuyo número, escrito en binario, tiene un 1 en el último lugar: la 1, la 3, la 5 y la 7. El segundo vigila las que tienen un 1 en el penúltimo: 2, 3, 6 y 7. El tercero, las que lo tienen en el antepenúltimo: 4, 5, 6 y 7. Cada paridad se ajusta para que el número de unos de su grupo sea par. Al recibir la palabra, el receptor rehace las tres comprobaciones. Si las tres cuadran, no ha habido error. Si alguna falla, se escribe un 1 por cada comprobación fallida y un 0 por cada correcta, en orden, y ese número binario —el síndrome (syndrome)— es la posición exacta del bit estropeado. Un error en la posición 6, que es 110 en binario, hace fallar la segunda y la tercera comprobación y no la primera; el síndrome 110 dice «6». Se voltea ese bit y el mensaje sale intacto. Los tres círculos de la figura son la misma idea dibujada: cada bit de datos está en la intersección de los círculos que lo vigilan, y los círculos que se ponen en naranja se cortan justo en el culpable.

El código tiene un límite, y la figura lo muestra en cuanto se estropean dos bits. El síndrome sigue señalando una posición, pero es la equivocada: el receptor «corrige» un bit sano y entrega un mensaje falso con toda confianza. La razón es una noción geométrica que Hamming introdujo en el mismo artículo y que lleva su nombre, la distancia: el número de bits en que difieren dos palabras. Las dieciséis palabras válidas del código (7,4) están todas a distancia tres o más unas de otras; un error las aleja una unidad de la palabra original y las deja aún a dos de cualquier otra, así que la más cercana es la correcta; con dos errores la palabra recibida queda a distancia uno de alguna otra palabra válida y el receptor la elige. Añadir un octavo bit que sea la paridad de los otros siete —el código (8,4) del segundo botón— no permite corregir dos errores, pero sí distinguir si ha habido uno o dos, y en el segundo caso pedir un reenvío en lugar de inventar. Es el compromiso que todo código tiene que elegir: cuántos bits de más enviar a cambio de cuántos errores corregir o detectar, y el botón que envía dos mil mensajes por un canal con ruido permite ver cómo cambia la cuenta según lo ruidoso que sea el canal.

Claude Shannon, en el despacho de al lado, había demostrado dos años antes algo que parecía imposible y que el código de Hamming hacía tangible: que por un canal con ruido se puede transmitir sin errores a una velocidad distinta de cero, siempre que se envíe redundancia bien elegida y no se pase de cierta capacidad. Shannon dijo qué era posible sin decir cómo; Hamming dio el primer cómo. Los que siguieron fueron más potentes y menos evidentes. Los códigos de Reed y Solomon de 1960 tratan los datos como coeficientes de un polinomio y corrigen ráfagas de errores consecutivos, y por eso están en los CD, donde una raya del disco borra miles de bits seguidos, en los códigos QR, que se leen con la mitad tapada, y en las sondas Voyager. Las memorias RAM de los servidores llevan una extensión del propio Hamming que corrige un bit y detecta dos, exactamente el código (8,4) de la figura a mayor escala. Y los códigos de comprobación de paridad de baja densidad que llevan el 5G y el wifi moderno rozan el límite de Shannon a costa de una decodificación que solo un ordenador puede hacer.

Hamming veía en su código algo más que una herramienta. En las conferencias que dio al final de su vida, recogidas en El arte de hacer ciencia e ingeniería, insistía en que la lección no era el código sino la pregunta: dejar de aceptar que la máquina se detuviera y preguntarse qué hacía falta para que no lo hiciera. La figura conserva esa pregunta. Un bit que cambia por el camino es un hecho del mundo, inevitable; que el mensaje llegue bien de todas formas es una decisión de diseño, y cuesta exactamente tres bits de cada siete. El resto del itinerario mira el otro lado del problema: qué pasa cuando el que cambia los bits no es el ruido sino un adversario, y para eso está la clave pública.

La codificación de Huffman – El sistema binario y el bit

Capítulo 5 de 8

La clave pública

Informática 1080 palabras artículo suelto ↗

La criptografía de clave pública (en inglés, public-key cryptography) resuelve el problema que ningún cifrado anterior había podido resolver: cómo dos personas que nunca se han visto y que solo pueden hablar por un canal que todo el mundo escucha acuerdan un secreto. Durante dos mil años, desde el cifrado de César hasta la libreta de un solo uso (one-time pad), cifrar exigía compartir antes una clave, y compartir la clave exigía un mensajero, una valija, un encuentro. En 1976 Whitfield Diffie y Martin Hellman mostraron que no hacía falta: dos personas podían intercambiar números a la vista de todos y acabar con un secreto común que ningún oyente puede calcular. Sin ese hallazgo no existiría el comercio electrónico, ni la banca en línea, ni la mensajería cifrada, ni el candado que aparece en el navegador.

El telegrama Zimmermann tal como lo recibió el embajador alemán en México el 19 de enero de 1917, cifrado con el código 0075 del Ministerio de Exteriores alemán y reenviado por Western Union. Los criptoanalistas británicos de la Sala 40 lo leyeron porque tenían el libro de códigos; el problema de todo cifrado hasta 1976 era que la clave había que llevarla físicamente, y todo lo que se lleva se puede robar.
Fig. 1 El telegrama Zimmermann tal como lo recibió el embajador alemán en México el 19 de enero de 1917, cifrado con el código 0075 del Ministerio de Exteriores alemán y reenviado por Western Union. Los criptoanalistas británicos de la Sala 40 lo leyeron porque tenían el libro de códigos; el problema de todo cifrado hasta 1976 era que la clave había que llevarla físicamente, y todo lo que se lleva se puede robar.Legación alemana en México / Western Union · 1917 · Dominio público · Wikimedia Commons

El problema se entiende con el caso más famoso de la Primera Guerra Mundial. En enero de 1917 el ministro alemán Arthur Zimmermann envió un telegrama a México proponiendo una alianza contra Estados Unidos, cifrado con un código de libro: cada palabra o sílaba era un grupo de cifras que había que buscar en un volumen que solo tenían las embajadas. Los británicos lo descifraron porque tenían copias parciales del libro, obtenidas de un barco hundido y de un agente en Persia. El código era bueno; lo que falló fue la distribución de la clave. Y esa es la debilidad estructural de toda la criptografía clásica: cuanto más gente necesita comunicarse en secreto, más claves hay que repartir por adelantado y más ocasiones de que una caiga en manos ajenas. Un ejército puede permitirse mensajeros; una red de millones de personas que compran, cobran y hablan entre sí, no.

Interactivo A la izquierda, el intercambio de Diffie y Hellman con números pequeños: Alicia y Benito eligen un secreto cada uno, se envían potencias de un número público, y calculan el mismo resultado sin haberse dicho nunca los secretos. Eva lo oye todo y aun así tiene que probar exponentes de uno en uno; el contador dice cuántos. A la derecha, RSA con dos primos de dos cifras: cualquiera cifra con la clave pública, solo quien sabe factorizar n descifra. Prueba con el primo más grande y mira crecer el trabajo de Eva.

La solución de Diffie y Hellman se apoya en una operación fácil de hacer y difícil de deshacer. Se elige un número primo p y un número g menor que él, los dos públicos. Alicia elige en secreto un número a y envía a Benito g elevado a a módulo p, es decir, el resto de dividir esa potencia entre p. Benito hace lo mismo con su secreto b. Cada uno eleva lo que ha recibido a su propio secreto, y los dos obtienen el mismo número, g elevado a a por b módulo p, porque el orden en que se elevan las potencias no importa. Eva, que ha oído p, g y las dos potencias, tendría que recuperar a a partir de g elevado a a: el logaritmo discreto (discrete logarithm). Con los números de dos cifras de la figura se hace probando, y el contador de Eva dice cuántas multiplicaciones necesita. Con el primo de siete cifras sigue siendo poco. Con los primos de seiscientas cifras que se usan hoy, no se conoce ningún método que termine en un tiempo comparable a la edad del universo, mientras que las potencias que calculan Alicia y Benito se hacen en milisegundos. La seguridad no está en que Eva no sepa cómo funciona el sistema —el sistema es público— sino en una asimetría de esfuerzo: multiplicar es barato y deshacer la multiplicación es caro.

Diffie y Hellman propusieron también, sin conseguir construirlo, algo más ambicioso: un cifrado en el que la clave para cerrar y la clave para abrir fueran distintas, de modo que una pudiera publicarse. Ron Rivest, Adi Shamir y Leonard Adleman lo construyeron en 1977, en el MIT, después de un año de intentos —Rivest cuenta que la idea le llegó una noche tras una cena de Pésaj— y se llama RSA por sus iniciales. Se toman dos primos grandes, p y q, y se publica su producto n junto con un exponente e. Cualquiera puede cifrar un mensaje m calculando m elevado a e módulo n. Para descifrar hace falta un exponente d que solo se puede calcular conociendo p y q por separado, y obtenerlos a partir de n es factorizar, el otro problema fácil de plantear y difícil de resolver de la aritmética. La tabla de la figura hace RSA con primos de dos cifras y muestra cada número: el cifrado, el descifrado que devuelve exactamente el mensaje, y las divisiones que necesita Eva para romperlo. Con un n de 617 cifras, el estándar actual, la mayor factorización (factorization) conseguida hasta hoy se queda muy lejos.

La clave pública trajo algo que la criptografía clásica no tenía: la firma. Si Alicia cifra un mensaje con su clave privada (private key), cualquiera puede descifrarlo con su clave pública, y el hecho de que salga algo con sentido demuestra que lo cifró ella y nadie más. Eso es una firma digital (digital signature), y con ella se resuelve el problema que ni Diffie-Hellman resuelve por sí solo: saber que el g elevado a b que llega viene de Benito y no de Eva haciéndose pasar por él. Los certificados que hay detrás del candado del navegador son firmas encadenadas: una autoridad firma la clave pública de un sitio web, y el navegador trae de fábrica las claves de las autoridades. En la práctica, los sistemas actuales usan la clave pública solo para acordar un secreto y firmar, y cifran el grueso del tráfico con un cifrado simétrico rápido con la clave acordada, porque las potencias de seiscientas cifras son lentas.

Dos notas para terminar. La primera es que el descubrimiento se hizo dos veces. James Ellis, Clifford Cocks y Malcolm Williamson, del servicio de cifrado británico GCHQ, habían encontrado entre 1970 y 1974 tanto la idea general como el equivalente de RSA y el de Diffie-Hellman, y no pudieron publicarlo; se supo en 1997, cuando el GCHQ desclasificó los informes. Ralph Merkle, estudiante en Berkeley, había propuesto en 1974 una manera distinta de acordar una clave en público, que su profesor rechazó como trabajo de curso, y que se publicó en 1978. La segunda es que la asimetría de esfuerzo es un hecho empírico, no un teorema: nadie ha demostrado que factorizar o calcular logaritmos discretos sea difícil, solo que nadie sabe hacerlo deprisa con los ordenadores que existen. Peter Shor demostró en 1994 que un ordenador cuántico suficientemente grande haría las dos cosas en un tiempo razonable, y por eso desde 2016 se estandarizan cifrados «poscuánticos» basados en otros problemas. La figura sirve también para eso: recorrer los primos de la lista hacia arriba y ver cómo crece el trabajo de Eva es ver, en pequeño, la apuesta sobre la que descansa toda la seguridad de internet.

Capítulo 6 de 8

La función hash criptográfica

Informática 1063 palabras artículo suelto ↗

Una función hash criptográfica (en inglés, cryptographic hash function) convierte cualquier cantidad de datos, una contraseña (password), un libro o una película entera, en una cadena corta de longitud fija que funciona como su huella dactilar (fingerprint). La más usada hoy, SHA-256, produce siempre 256 bits, que se suelen escribir como 64 cifras hexadecimales. La misma entrada da siempre la misma huella, pero la huella no permite reconstruir la entrada, y dos entradas distintas, aunque se parezcan en todo menos en una coma, dan huellas que no se parecen en nada. Con esas tres propiedades se comprueba que un programa descargado no ha sido manipulado, se guardan contraseñas sin guardarlas, se firman documentos y se encadenan los bloques de Bitcoin.

La figura de esta página calcula SHA-256 en el navegador, sin enviar nada a ningún servidor. Las dos primeras rejillas son los 256 bits de la huella de dos textos, A y B, pintados en negro los unos y en blanco los ceros; la tercera marca en naranja los bits en que difieren. Los dos textos de partida solo se distinguen en una mayúscula, la de «Mancha», que en la codificación de los ordenadores es un único bit, y sin embargo las huellas difieren en cerca de la mitad de sus bits. El botón que cambia un bit al azar de A permite repetir el experimento tantas veces como se quiera, y el resultado se queda siempre alrededor de 128 de 256.

Interactivo Escribe dos textos o pulsa el botón para que B sea A con un solo bit cambiado: la huella cambia en torno a la mitad de sus 256 bits. Abajo, recorta la huella a sus primeros bits y busca dos textos que coincidan en ellos. La búsqueda tarda mucho menos de lo que sugiere el número de valores posibles.

Ese comportamiento se llama efecto avalancha (avalanche effect), y es la propiedad que distingue una función criptográfica de las funciones hash corrientes, como las que reparten las claves de una tabla hash. Aquellas solo necesitan esparcir bien los datos y ser rápidas; esta tiene que resistir a alguien que busca a propósito. Se le piden tres resistencias, de menor a mayor exigencia en la práctica. La primera es que, dada una huella, no se pueda encontrar ninguna entrada que la produzca, lo que la hace útil para contraseñas. La segunda, que dado un mensaje no se pueda encontrar otro distinto con la misma huella, lo que impide sustituir un documento firmado. La tercera, que no se puedan encontrar dos mensajes cualesquiera con la misma huella, lo que se llama una colisión (collision). Colisiones hay por fuerza, infinitas, porque hay infinitos mensajes y solo 2²⁵⁶ huellas; lo que se exige es que nadie sea capaz de encontrar una.

La segunda parte de la figura enseña por qué la tercera resistencia es la más débil. Si se recorta la huella a sus primeros 24 bits, hay unos dieciséis millones de valores posibles, y parecería que habría que probar millones de textos para que dos coincidieran. No hace falta: la figura calcula las huellas de «ikusmira-0», «ikusmira-1» y así sucesivamente, y encuentra una pareja, de media, hacia los cinco mil intentos; la primera vez que se pulsa el botón aparece en el intento 1.136, entre «ikusmira-236» y «ikusmira-1135», que empiezan las dos por las mismas seis cifras hexadecimales. Es la paradoja del cumpleaños, la misma que hace que en un grupo de veintitrés personas sea más probable que improbable que dos cumplan años el mismo día: lo que crece deprisa no es el número de personas sino el de parejas. Para una huella de n bits, la primera colisión llega hacia los 2^(n/2) intentos, la raíz cuadrada del número de valores. Por eso SHA-256 ofrece 128 bits de seguridad frente a colisiones, no 256, y por eso las funciones de 128 bits, como MD5, nacieron con una seguridad teórica de solo 64.

Casi todas las funciones de esta familia se construyen igual. Ralph Merkle e Ivan Damgård demostraron por separado, en el congreso CRYPTO de 1989, que basta con saber comprimir bien un bloque de tamaño fijo: se parte el mensaje en bloques, se rellena el último añadiendo la longitud total, y se pasa cada bloque por una función de compresión junto con el resultado del bloque anterior. Si la función de compresión resiste las colisiones, la cadena entera también. SHA-256 trocea el mensaje en bloques de 512 bits y los mezcla con un estado de 256 en 64 rondas de sumas, rotaciones y operaciones lógicas, con constantes sacadas de las raíces cúbicas de los primeros números primos, elegidas así para demostrar que no esconden nada. La figura usa exactamente ese procedimiento, escrito en unas treinta líneas.

La historia de estas funciones es la de sus roturas. MD5, que Ronald Rivest diseñó en 1991, fue durante una década la huella estándar de internet, hasta que Xiaoyun Wang y Hongbo Yu presentaron en 2005 un método para fabricar colisiones en horas. En 2012 se descubrió que el programa espía Flame había usado una colisión de MD5 para falsificar un certificado de Microsoft y hacerse pasar por una actualización de Windows. SHA-1, publicada por el gobierno estadounidense en 1995, duró más: en 2017, un equipo de Google y del instituto de investigación CWI de Ámsterdam publicó dos ficheros PDF distintos con la misma huella SHA-1, tras un cálculo de unos nueve trillones de operaciones, el equivalente a más de seis mil años de un procesador. SHA-256 pertenece a la familia SHA-2, de 2001, y no se le conoce ningún ataque práctico, pero la norma tiene ya un relevo, SHA-3, elegida en 2012 en un concurso público y construida sobre un principio distinto por si algún día la familia anterior cede.

Las contraseñas merecen un párrafo aparte, porque son el uso donde la velocidad de la función juega en contra. Robert Morris y Ken Thompson explicaron en 1979 cómo Unix guardaba, en lugar de las contraseñas, su huella, y cómo le añadía a cada una un valor al azar, la sal (salt), para que dos usuarios con la misma contraseña no tuvieran la misma huella y no sirviera de nada una tabla precalculada. El problema es que SHA-256 está hecha para ser rápida: la figura calcula decenas de miles de huellas en un instante, y una tarjeta gráfica prueba miles de millones de contraseñas por segundo. Por eso las contraseñas se guardan con funciones lentas a propósito, como bcrypt o Argon2, que hacen el cálculo miles de veces seguidas. Una función hash criptográfica garantiza que la huella no se puede invertir; no garantiza que la contraseña no se pueda adivinar.

El problema del cumpleaños – El sistema binario y el bit

Capítulo 7 de 8

La tabla hash

Informática 939 palabras artículo suelto ↗

La tabla hash (en inglés, hash table) es la estructura de datos (data structure) que permite guardar y encontrar cosas por su nombre en un tiempo que no depende de cuántas cosas haya. Es lo que hay detrás de los diccionarios de Python, los objetos de JavaScript, los índices de las bases de datos en memoria y las cachés de casi cualquier programa. La idea es de una audacia que sigue sorprendiendo cuando se ve por primera vez: en lugar de buscar la clave comparándola con las que ya hay, se calcula a partir de la propia clave, con una fórmula, el lugar donde debería estar, y se va directamente allí. La fórmula es la función hash (hash function); el lugar, una cubeta de un vector; y el problema que da lugar a toda la teoría es qué hacer cuando dos claves distintas caen en la misma cubeta, que es inevitable y se llama colisión (collision).

La figura de esta página es una tabla hash con las cubetas a la vista. Cada palabra que se inserta pasa por la función hash elegida, el resultado se divide por el número de cubetas, y el resto dice en cuál cae. Con el método de encadenamiento (chaining), cada cubeta es una lista y las palabras que colisionan se apilan en ella; buscar una palabra es ir a su cubeta y recorrer la lista. Con el de direccionamiento abierto (open addressing), cada cubeta guarda una sola palabra, y la que encuentra la suya ocupada avanza a la siguiente libre; buscar es ir a la cubeta y avanzar hasta encontrar la palabra o un hueco vacío. Los dos métodos son de los años cincuenta: Arnold Dumey publicó el primero en 1956, con la observación de que un resto de división reparte bien las claves, y Wesley Peterson analizó el segundo en 1957 para los discos de IBM.

Interactivo Una tabla hash con sus cubetas. Inserta palabras del corpus de Ikusmira o las tuyas, cambia el número de cubetas y la función hash, y busca una palabra para ver el camino que recorre. La suma de letras es una función hash real y mala; FNV-1a, una real y buena. En direccionamiento abierto, mira lo que pasa con los sondeos cuando la tabla pasa del 80 % de ocupación.

Lo que la figura enseña primero es que la función hash lo es todo. La suma de los códigos de las letras es una función hash legítima —siempre da el mismo número para la misma palabra— y es pésima: las palabras de longitud parecida suman cantidades parecidas y caen en cubetas vecinas, dos anagramas caen en la misma, y con dieciséis cubetas la mayoría de las palabras acaban en tres o cuatro de ellas mientras el resto quedan vacías. Una función buena, como FNV-1a, mezcla cada letra con las anteriores de manera que cambiar una sola letra cambia el resultado entero de forma impredecible, y las palabras se reparten como si se hubieran lanzado al azar. Esa es la propiedad que se pide: no que la función sea aleatoria, sino que se comporte como si lo fuera. Lawrence Carter y Mark Wegman demostraron en 1979 que eligiendo la función hash al azar de una familia adecuada se garantiza ese comportamiento para cualquier conjunto de claves, incluso uno elegido por un adversario, lo que hoy importa porque una tabla hash con una función predecible se puede atacar llenándola de colisiones a propósito.

Lo segundo es el factor de carga (load factor), la fracción de cubetas ocupadas, que la figura llama α. Con encadenamiento, si las claves se reparten bien, la longitud media de una lista es α y buscar una clave que está cuesta de media 1 + α/2 comparaciones; con α = 2 son dos, con α = 10 son seis, y la tabla degenera en una lista corriente. Con direccionamiento abierto la cosa es más brusca: Donald Knuth calculó en 1963, en el que cuenta como su primer análisis de un algoritmo, que buscar con sondeo lineal cuesta de media ½(1 + 1/(1 − α)) sondeos, que vale 1,5 con la tabla medio llena, 3 al 80 % y 50 al 99 %. La figura reproduce esa curva: al insertar palabras en una tabla pequeña con direccionamiento abierto, los sondeos se disparan al llenarse, y llega un momento en que no cabe nada. Por eso las tablas reales se agrandan solas cuando α supera un límite, típicamente entre 0,7 y 0,9, copiando todo a un vector del doble de tamaño. Esa copia cuesta, pero se hace pocas veces, y repartida entre todas las inserciones sale a coste constante.

Lo tercero es qué significa «tiempo constante». Una tabla hash no promete que cada búsqueda cueste lo mismo; promete que el promedio no crece con el número de claves, siempre que la función reparta bien y la carga se mantenga a raya. La peor búsqueda posible puede recorrer todas las claves, y hay variantes, como el hashing cuco de Rasmus Pagh y Flemming Rodler de 2004, que garantizan como mucho dos sondeos en cualquier búsqueda a cambio de una inserción más complicada. Pero el promedio es lo que hace útil la estructura, y es lo que la hace distinta de los árboles de búsqueda, que garantizan un coste logarítmico en el peor caso a cambio de no alcanzar nunca el constante.

La tabla hash es también un buen ejemplo de una idea que reaparece en toda la informática: cambiar orden por aleatoriedad. Un vector ordenado permite buscar en tiempo logarítmico porque el orden dice hacia dónde ir; una tabla hash renuncia al orden —sus claves no se pueden recorrer de menor a mayor— y a cambio va directa. La figura muestra esa renuncia en el desorden de las cubetas: las palabras están donde su hash las mandó, sin relación con su alfabeto ni con su llegada. Es la misma apuesta que hacen el filtro de Bloom y buena parte de los algoritmos probabilistas: aceptar que el peor caso exista, y organizar las cosas para que casi nunca ocurra.

La búsqueda binaria – El árbol binario de búsqueda – El filtro de Bloom – La función hash criptográfica

Capítulo 8 de 8

El filtro de Bloom

Informática 989 palabras artículo suelto ↗

El filtro de Bloom (en inglés, Bloom filter) es una estructura de datos (data structure) que responde a la pregunta «¿he visto ya este elemento?» usando una cantidad de memoria ridícula, a cambio de equivocarse a veces en una sola dirección. Nunca dice que no ha visto algo que sí vio. Puede decir que ha visto algo que no vio, con una probabilidad pequeña y calculable. Esa asimetría lo hace perfecto como portero: antes de hacer una operación cara —consultar un disco, preguntar a otro servidor, buscar en una lista de millones de direcciones maliciosas—, se pregunta al filtro, y si dice «no» se ahorra la operación con toda seguridad; si dice «quizá», se hace la operación y se comprueba. Burton Bloom lo propuso en 1970 en cuatro páginas, y hoy está en los navegadores, en las bases de datos, en los routers y en las criptomonedas.

La figura de esta página es un filtro de Bloom entero, bit a bit. La rejilla de la izquierda es un vector de m bits (bit array), todos a cero al principio. Insertar una palabra es pasarla por k funciones hash (hash functions) distintas, que dan k posiciones del vector, y poner a uno esos k bits. Consultar una palabra es calcular sus mismas k posiciones y mirar: si alguno de los bits está a cero, la palabra no se ha insertado, con certeza absoluta, porque de haberse insertado ese bit estaría a uno. Si todos están a uno, la palabra probablemente se insertó, pero puede que no: puede que otros elementos, entre todos, hayan encendido por casualidad esos k bits. Eso es un falso positivo (false positive), y el botón que consulta una palabra que no está permite ir a la caza de uno.

Interactivo Un filtro de Bloom con sus bits. Inserta palabras del corpus de Ikusmira y consulta las que quieras: los bits de la consulta se marcan en naranja, y un bit apagado basta para decir que no. La gráfica mide la tasa de falsos positivos con quinientas palabras que no se han insertado y la compara con la fórmula. Sube el número de funciones sin subir los bits y mira cómo el filtro se llena.

Lo primero que se ve es cuánto cabe. El vector de 256 bits de la figura ocupa 32 bytes, lo que ocuparían cinco o seis palabras cortas escritas tal cual, y sin embargo con tres funciones hash puede guardar la huella de cuarenta palabras y responder mal a menos del 10 % de las consultas sobre palabras ausentes. Con 1.024 bits y cien palabras, el error baja del 2 %. El filtro no guarda las palabras: no se pueden recuperar de él ni recorrer, solo preguntar por una. Esa es la renuncia que compra el ahorro, y el motivo de que el filtro complemente a otras estructuras en lugar de sustituirlas.

Lo segundo es la fórmula, que la gráfica de la derecha dibuja junto a la medida real. Tras insertar n elementos con k funciones en m bits, la fracción de bits que sigue a cero es aproximadamente e^(−kn/m), y la probabilidad de que una palabra ausente encuentre sus k bits encendidos es esa fracción de bits encendidos elevada a k. La medida de la figura, hecha con quinientas palabras que no están, sigue la curva teórica con el vaivén que corresponde a una muestra de ese tamaño. La fórmula dice también cuántas funciones conviene usar: con pocas, cada palabra deja poca huella y una ausente la imita fácilmente; con muchas, el vector se llena de unos y todo parece estar. El óptimo es k = (m/n)·ln 2, unas 0,7 funciones por cada bit disponible por elemento, y con él la tasa de error es 0,6185 elevado a m/n: con diez bits por elemento, menos del 1 %. La figura calcula el óptimo para el número de palabras insertadas y avisa cuando el k elegido se aleja.

Lo tercero es de dónde salen k funciones hash. Calcular ocho funciones distintas por cada consulta sería caro, y en la práctica no hace falta. Adam Kirsch y Michael Mitzenmacher demostraron en 2008 que basta con dos funciones, h₁ y h₂, y usar h₁ + i·h₂ para i de 0 a k − 1, sin que la tasa de falsos positivos empeore de forma apreciable. Es lo que hace la figura, con dos variantes de la función FNV, y es lo que hacen la mayoría de las implementaciones.

El filtro tardó treinta años en hacerse famoso, y lo que lo lanzó fue la red. Li Fan y sus colegas propusieron en 2000 que las cachés web de una organización se intercambiaran, en lugar de la lista completa de las páginas que cada una tenía, un filtro de Bloom de esa lista: una fracción de la memoria, y a cambio alguna consulta ocasional a una caché vecina que resultaba no tener la página. Andrei Broder y Michael Mitzenmacher recopilaron en 2004 decenas de usos en redes y acuñaron el principio del filtro de Bloom: siempre que una lista o un conjunto se usen y el espacio importe, considérese un filtro de Bloom si los falsos positivos se pueden tolerar. Bigtable, la base de datos de Google descrita en 2008, guarda un filtro por cada fichero en disco para no leer ficheros que no contienen la clave buscada, y la idea se copió en casi todos los almacenes de datos posteriores. Chrome usó durante años un filtro de Bloom con las direcciones peligrosas conocidas, para consultar al servidor solo cuando el filtro decía «quizá». Bitcoin lo usa para que un cliente ligero pida a la red solo las transacciones que le pueden interesar sin revelar cuáles son.

Hay una limitación que la figura hace visible: no se puede borrar. Poner a cero los bits de una palabra apagaría también los de otras que los compartan, y el filtro empezaría a dar falsos negativos, lo único que prometía no dar. Las variantes con contadores en lugar de bits lo permiten a cambio de más memoria. Pero la versión original, la de 1970, sigue siendo la que se usa cuando lo que hay que recordar solo crece, y su lección va más allá del caso: hay preguntas cuya respuesta exacta cuesta mucho y cuya respuesta casi exacta, con el error en la dirección correcta, cuesta casi nada.

La tabla hash

Este itinerario ordena artículos de la enciclopedia; cada uno vive también suelto, con sus fuentes y su historial. ¿Le falta un capítulo o le sobra uno? Dínoslo.

Todos los itinerarios →