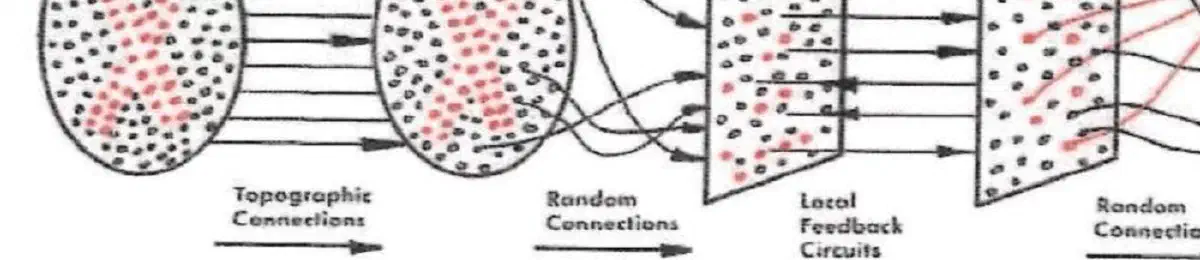
Organización de un cerebro biológico y de un perceptrón — Cómo aprende una máquina
Frank Rosenblatt, 1958 · Public domain · Wikimedia Commons
Itinerarios / medio

Cómo aprende una máquina

Trece piezas para ver por dentro un sistema que aprende, desde el paso cuesta abajo con que se entrena hasta el modelo que predice la palabra siguiente.

13 capítulos · 11,699 palabras · 59 min · cada capítulo es un artículo de la enciclopedia

Trece piezas para ver por dentro un sistema que aprende, con una figura en cada una y sin metáforas de cerebro. No hace falta más matemática que la del instituto. Van en tres bloques, y cada uno deja una pregunta para juzgar cualquier sistema de IA.

El primero es cómo aprende. Casi todo se entrena con el descenso de gradiente: mirar hacia dónde baja el error y dar un paso en esa dirección. El perceptrón y la red neuronal apilan unidades simples sobre esa idea, y el árbol de decisión y k-medias enseñan otras dos maneras de aprender. La pregunta que deja el sobreajuste es la más útil del itinerario: ¿con qué datos se ha medido? Un modelo que acierta todo lo que ha visto es sospechoso, no admirable. Solo cuenta el acierto sobre datos que no usó para entrenarse.

El segundo es cómo se equivoca. Una prueba que acierta el noventa por ciento de las veces puede fallar en nueve de cada diez positivos si lo que busca es raro. Antes de fiarse de un detector de fraude o de spam, hay que preguntar cuántos casos reales hay. La curva ROC enseña dónde se pone el umbral entre falsas alarmas y casos perdidos, y cuando lo buscado es raro engaña menos la curva de precisión frente a sensibilidad.

El tercero es el lenguaje, y nosotros. La ley de Zipf y el modelo de n-gramas enseñan la idea de todos los modelos de lenguaje, predecir la palabra siguiente, y Jev la contraria: un modelo que no escribe y responde con probabilidades que miden su propia duda. El efecto ELIZA avisa de que atribuimos comprensión a un programa aunque sepamos cómo funciona, y saberlo no lo corrige. La paradoja de Moravec explica por qué lo que a un niño no le cuesta nada es lo más difícil de automatizar.

Si solo hay tiempo para dos capítulos, el sobreajuste y el falso positivo.

Capítulo 1 de 13

El descenso de gradiente

Informática 952 palabras artículo suelto ↗

El descenso de gradiente (en inglés, gradient descent) es el método con el que se entrena casi todo lo que hoy se llama inteligencia artificial (artificial intelligence). Consiste en algo muy simple: para encontrar el punto más bajo de una superficie, mirar hacia dónde baja más deprisa el terreno bajo los pies y dar un paso en esa dirección; repetir hasta que el suelo sea llano. La superficie es el error de un modelo en función de sus parámetros; el punto más bajo, los parámetros que menos se equivocan; y el «hacia dónde baja más deprisa» lo dice el gradiente, el vector de derivadas parciales, que apunta cuesta arriba y cuyo opuesto es el camino de bajada más empinado. Una red neuronal con miles de millones de parámetros se entrena exactamente así, solo que en un espacio de miles de millones de dimensiones que nadie puede dibujar.

La figura de esta página lo hace en dos dimensiones, que sí se dibujan. Las curvas de nivel (contour lines) muestran la altura de una función; el punto naranja es la posición actual, y cada paso lo desplaza en dirección contraria al gradiente una distancia proporcional a la pendiente y a un número que el usuario controla: la tasa de aprendizaje (learning rate). Con ella empieza casi todo lo que hay que saber sobre el método. Si es pequeña, el punto baja con seguridad y con una lentitud exasperante. Si es grande, salta al otro lado del valle, y si es demasiado grande cada salto lo aleja más del fondo hasta que sale del mapa: el error crece en vez de bajar, que es lo que en la práctica se llama que el entrenamiento ha divergido.

Interactivo Curvas de nivel de tres funciones (más oscuro, más bajo) y el camino del descenso desde el punto que elijas. Mueve la tasa de aprendizaje y observa cuándo el camino se vuelve lento, cuándo zigzaguea y cuándo se dispara. El valle curvo y la función con varios mínimos son los dos problemas clásicos; el botón de momento es la solución clásica a ambos.

La idea es de Cauchy, que la propuso en 1847 en una nota de cuatro páginas para resolver sistemas de ecuaciones, y durante un siglo fue un método más entre los de la optimización numérica, más lento que los que usan también la curvatura, como el de Newton. Su fortuna cambió cuando los problemas se hicieron grandes. Calcular la curvatura de una función de un millón de parámetros exige una matriz de un billón de números; calcular su gradiente cuesta lo mismo que evaluar la función una vez. Herbert Robbins y Sutton Monro mostraron en 1951 que el método sigue funcionando aunque el gradiente se estime con ruido a partir de una muestra de los datos, y esa variante, el descenso de gradiente estocástico, es la que se usa: en lugar de calcular el error sobre todos los ejemplos antes de cada paso, se calcula sobre unos cuantos, y se dan muchos pasos pequeños e imprecisos en vez de pocos exactos. Léon Bottou argumentó en 2010 que, con datos de sobra, esa imprecisión sale gratis y la velocidad no.

La segunda función de la figura, un valle curvo y estrecho tomado de la función de Rosenbrock, enseña el defecto principal del método. En un valle así, el gradiente apunta casi perpendicular a las paredes y casi nada hacia la salida, así que el punto rebota de una pared a otra avanzando muy poco por el fondo. La solución que propuso Boris Polyak en 1964 es el momento (momentum): en lugar de moverse según el gradiente actual, el punto acumula una velocidad que promedia los gradientes recientes; los rebotes laterales se cancelan y el avance a lo largo del valle se suma. El botón de la figura lo activa, y el zigzag se convierte en una curva que recorre el fondo. Los optimizadores que se usan hoy para entrenar redes grandes, como Adam, propuesto por Kingma y Ba en 2015, combinan el momento con una tasa de aprendizaje distinta para cada parámetro, ajustada según lo que ha variado su gradiente.

La tercera función tiene varios hoyos, y muestra la limitación que ningún ajuste de la tasa resuelve: el descenso de gradiente solo garantiza llegar a un mínimo, el del valle donde empezó, y no tiene forma de saber si hay otro más bajo detrás de la loma. Cuando el punto se detiene, el gradiente es cero, y desde dentro del algoritmo un mínimo local (local minimum) es indistinguible del global. Al pulsar en distintos puntos de partida de la figura se acaba en fondos distintos. Durante años se pensó que esto haría inviable entrenar redes neuronales profundas, cuyas funciones de error tienen un número astronómico de mínimos locales; la experiencia ha enseñado que en dimensiones muy altas la mayoría de esos mínimos son casi igual de buenos, y que el verdadero obstáculo son las mesetas y los puntos de silla, regiones enormes de pendiente casi nula donde el método se arrastra.

Lo que hizo del descenso de gradiente la herramienta central del aprendizaje automático fue un cálculo, no una idea nueva. Para dar un paso hace falta el gradiente del error respecto a cada parámetro, y en una red con muchas capas eso parecía exigir un cálculo distinto por parámetro. El algoritmo de retropropagación, que Rumelhart, Hinton y Williams publicaron en 1986 en Nature aunque lo habían anticipado otros, obtiene todos a la vez con una sola pasada hacia atrás por la red, aplicando la regla de la cadena capa a capa: cuesta lo mismo que evaluar la red dos veces. Con eso, la receta completa cabe en una frase. Pasar un lote de ejemplos por la red, medir el error, retropropagarlo para obtener el gradiente, dar un paso cuesta abajo, y repetirlo millones de veces. La figura hace lo mismo con dos parámetros en lugar de miles de millones, y las dificultades que se ven en ella —la tasa, el zigzag, los mínimos donde uno se queda atrapado— son las mismas que ocupan a quien entrena un modelo grande.

La red neuronal – El método de Newton – La derivada – El perceptrón

Capítulo 2 de 13

El perceptrón

Informática 810 palabras artículo suelto ↗

El perceptrón (en inglés, perceptron) es la neurona artificial (artificial neuron) más simple que aprende, y el antepasado directo de las redes neuronales (neural networks) actuales. Recibe varios números de entrada, multiplica cada uno por un peso (weight), suma los productos y decide: si la suma supera un umbral (threshold) responde sí, y si no, no. Lo que lo distingue de una simple fórmula es que los pesos no los fija nadie; los ajusta una regla de aprendizaje (learning rule) a partir de ejemplos etiquetados. Frank Rosenblatt lo propuso en 1958, lo construyó en hardware con potenciómetros movidos por motores, y anunció que era el embrión de una máquina capaz de percibir, reconocer e identificar sin programación humana. La prensa habló de un cerebro electrónico. Once años después, un libro demostró lo que el perceptrón no podía hacer, y la financiación de la investigación en redes neuronales se secó durante más de una década.

La figura de esta página es un perceptrón de dos entradas, que se puede ver entero. Cada punto del plano es un ejemplo con dos coordenadas y una clase, negra o naranja; los pesos definen una recta, y el perceptrón responde «naranja» a un lado y «negra» al otro. La regla de aprendizaje de Rosenblatt es de una sencillez desarmante: se recorren los ejemplos, y cada vez que uno está mal clasificado se suman sus coordenadas a los pesos si debía ser naranja, o se restan si debía ser negra. Eso gira y desplaza la recta hacia el punto equivocado. Los que están bien clasificados no tocan nada. Una pasada completa por los ejemplos es una época, y el algoritmo repite épocas hasta que una pasa sin errores.

Interactivo Dos clases de puntos y la recta del perceptrón. Entrena época a época y mira cómo la recta se mueve solo cuando se equivoca. Añade puntos con el botón de la clase. El tercer conjunto, XOR, es el ejemplo con el que Minsky y Papert mostraron el límite: no hay recta que lo separe, y el perceptrón nunca se detiene.

Lo notable es que la regla funciona, y que se puede demostrar. Albert Novikoff probó en 1962 el teorema de convergencia del perceptrón: si existe alguna recta que separa las dos clases, el algoritmo la encuentra en un número finito de correcciones, que depende de lo estrecho que sea el margen entre las clases y no del número de ejemplos. Con las nubes separables de la figura, eso ocurre en unas pocas épocas. Con las nubes que se solapan, no hay recta sin errores y el perceptrón sigue moviéndola para siempre, cada vez empujada por los puntos que quedan del lado equivocado; en la práctica se detiene el entrenamiento y se guarda la mejor recta vista, pero el algoritmo en sí no tiene manera de saber que ha terminado.

El tercer conjunto de la figura es el que dio nombre a una crisis. La función XOR, «o exclusivo», es naranja cuando las dos coordenadas tienen el mismo signo y negra cuando tienen signos distintos: cuatro grupos en las cuatro esquinas, con los del mismo color en diagonal. Ninguna recta los separa, y un perceptrón de una sola capa no puede aprenderla, por muchas épocas que se le den. Marvin Minsky y Seymour Papert dedicaron el libro Perceptrons de 1969 a demostrar con rigor esta y otras limitaciones —el perceptrón tampoco puede decidir si una figura está conectada, ni contar la paridad de sus entradas sin un peso por cada combinación—, y el libro se leyó como una sentencia contra toda la línea de investigación. Rosenblatt murió en 1971 en un accidente de barco, y la historia oficial cuenta que el campo entró en un «invierno» hasta mediados de los años ochenta.

Esa historia es discutida. Mikel Olazaran mostró en 1996 que Minsky y Papert sabían perfectamente, y escribieron, que un perceptrón con una capa intermedia de neuronas sí resuelve el XOR; lo que no existía era un método para entrenar esa capa intermedia, porque la regla de Rosenblatt necesita saber cuál debía ser la salida de cada neurona, y de las intermedias nadie lo sabe. Su escepticismo era que ese método pudiera encontrarse. La retropropagación, difundida en 1986, resolvió justo ese problema, y la red de dos capas que aprende el XOR es hoy el primer ejercicio de cualquier curso. El perceptrón no estaba equivocado: estaba incompleto.

Lo que sí sigue vigente, casi sin cambios, es la anatomía. Una neurona de las redes actuales hace lo mismo que la de Rosenblatt: suma ponderada de las entradas más un sesgo (bias), y una función que decide; solo ha cambiado esa función, de un escalón brusco a curvas suaves que se pueden derivar, porque el descenso de gradiente necesita pendientes. Los pesos siguen siendo lo que se aprende, y la regla de Rosenblatt es, con la notación de hoy, un paso de descenso de gradiente sobre el error de clasificación. Cuando en la figura la recta gira hacia el punto que se le resistía, se está viendo el mismo gesto que, repetido en miles de millones de pesos, produce los sistemas que hoy reconocen caras y traducen idiomas: corregir un poco en la dirección del error, y volver a mirar.

La red neuronal – El árbol de decisión – El descenso de gradiente

Capítulo 3 de 13

La red neuronal

Informática 888 palabras artículo suelto ↗

Una red neuronal (en inglés, neural network) es una función matemática compuesta por capas (layers) de unidades simples, cada una de las cuales suma sus entradas con unos pesos (weights) y aplica una curva, cuyos pesos se ajustan a partir de ejemplos mediante descenso de gradiente (gradient descent). El nombre viene de una analogía con el cerebro que ya no guía a nadie: lo que importa no es que las unidades se parezcan a neuronas, sino que al encadenarlas en capas la función resultante puede tomar casi cualquier forma, y que existe un método eficiente para encontrar los pesos que le dan la forma que los datos piden. Con dos capas y unas pocas unidades, la red de esta página aprende a separar formas que ninguna recta separa; con cientos de capas y miles de millones de pesos, la misma construcción reconoce imágenes, transcribe voz y escribe texto.

La figura entrena una red pequeña ante los ojos del lector. Tiene dos entradas, las coordenadas de un punto; una capa oculta (hidden layer) de entre una y ocho neuronas, cada una con una tangente hiperbólica que aplasta la suma en el intervalo de −1 a 1; y una salida que da la probabilidad de que el punto sea naranja. El fondo del plano muestra lo que la red cree en cada lugar, y los puntos, lo que es verdad. Al empezar, los pesos son aleatorios y el fondo es un borrón sin sentido. Cada paso de entrenamiento toma dieciséis puntos, mide cuánto se equivoca la red con ellos, calcula por retropropagación (backpropagation) cuánto contribuye cada peso al error y mueve todos los pesos un poco en la dirección que lo reduce. La curva de la derecha registra ese error, y el esquema de abajo muestra los pesos con el grosor y el color de cada conexión.

Interactivo Una red de dos entradas, una capa oculta y una salida, entrenándose sobre cuatro conjuntos. El fondo es la frontera de decisión: lo que la red respondería en cada punto. Prueba el XOR con una sola neurona oculta y luego con cuatro; prueba la espiral con ocho. El esquema de abajo dibuja los pesos: naranja positivos, azul negativos, más gruesos cuanto mayores.

Lo primero que enseña la figura es para qué sirve la capa oculta. El perceptrón de una capa solo traza una recta; cada neurona oculta de esta red traza también una recta, pero la salida combina las de todas, y la frontera resultante puede doblarse tantas veces como neuronas haya. Con una sola neurona oculta el XOR es imposible, igual que para el perceptrón. Con dos ya se puede, aunque no siempre lo consigue, y con cuatro lo aprende en unos cientos de pasos. El círculo dentro del anillo necesita que la frontera se cierre sobre sí misma, cosa que tres o cuatro rectas combinadas hacen bien. La espiral, que da dos vueltas, pide más: con ocho neuronas la red suele conseguirla pero tarda, y a veces se atasca en una solución a medias. George Cybenko demostró en 1989, y Kurt Hornik generalizó en 1991, que una red de una sola capa oculta con suficientes neuronas puede aproximar cualquier función continua tanto como se quiera. El teorema no dice cuántas neuronas hacen falta ni cómo encontrar los pesos; la figura da una idea de ambas cosas.

Lo segundo es que el entrenamiento es un proceso, no una fórmula. La curva de pérdida baja a tirones, se estanca en mesetas y a veces cae de golpe cuando la red «descubre» una estructura de los datos. Dos entrenamientos con los mismos datos, la misma arquitectura y distintos pesos iniciales terminan en fronteras distintas, a menudo igual de buenas. Y la tasa de aprendizaje manda como en cualquier descenso de gradiente: demasiado baja y no pasa nada en miles de pasos, demasiado alta y la pérdida oscila o se dispara. El botón de reiniciar los pesos permite comprobar cuánto depende el resultado de dónde se empieza.

El algoritmo que hace posible todo esto tiene nombre y fecha. La retropropagación, que Rumelhart, Hinton y Williams presentaron en 1986, resolvió el problema que había frenado las redes desde el perceptrón: cómo saber qué debe hacer una neurona intermedia, cuya salida correcta nadie conoce. La respuesta es no preguntárselo. Se mide el error en la salida y se propaga hacia atrás, capa a capa, con la regla de la cadena del cálculo, de modo que cada peso recibe la parte del error que le corresponde. En la figura eso ocurre dieciséis puntos y dieciséis veces por cada tic del reloj, y es lo mismo que ocurre, con más capas y más pesos, en cualquier red moderna.

Durante veinte años las redes así entrenadas fueron una técnica más, con éxitos en el reconocimiento de dígitos manuscritos y poco más, y a menudo peores que alternativas más sencillas. Lo que cambió no fue la idea sino la escala. En 2012, Krizhevsky, Sutskever y Hinton entrenaron en dos tarjetas gráficas una red de ocho capas con sesenta millones de pesos sobre un millón de imágenes etiquetadas, y ganaron el concurso ImageNet con un margen que dejó obsoleto todo lo demás. El aprendizaje profundo, como resumieron LeCun, Bengio y Hinton en 2015, es esa misma red de la figura con muchas más capas, muchos más datos y muchas más máquinas; las capas sucesivas aprenden representaciones cada vez más abstractas de la entrada, bordes, luego texturas, luego partes, luego objetos, sin que nadie las diseñe. La figura de esta página no puede mostrar eso, pero sí lo esencial: una función ajustable, un error que se mide y un gradiente que se sigue, hasta que el fondo del plano y los puntos dicen lo mismo.

El perceptrón – El descenso de gradiente – El árbol de decisión – El sobreajuste

Capítulo 4 de 13

El sobreajuste

Informática 903 palabras artículo suelto ↗

El sobreajuste (en inglés, overfitting) es lo que le ocurre a un modelo que aprende demasiado bien los datos con los que se ha entrenado: se ajusta no solo a la regularidad que hay en ellos sino también al ruido (noise), a los accidentes de esa muestra concreta, y por eso falla con datos nuevos. Es el problema central del aprendizaje automático (machine learning), porque un modelo no se construye para repetir lo que ya se sabía sino para acertar con lo que aún no se ha visto, y porque la única medida que se tiene a mano mientras se entrena —el error sobre los ejemplos conocidos— es precisamente la que el sobreajuste hace bajar. Un modelo sobreajustado parece mejor cuanto peor es.

La figura de esta página lo muestra con la versión más antigua del problema, el ajuste de un polinomio a unos puntos. Los puntos negros son muestras de una onda, la curva gris, a las que se ha sumado ruido. El polinomio naranja es el que mejor los ajusta por mínimos cuadrados, y su grado —la cantidad de curvas que puede hacer— lo controla el deslizador. Con grado 1 es una recta, que no puede seguir la onda y se equivoca con todos los puntos por igual: es lo que se llama infraajuste, un modelo demasiado rígido para la realidad. Con grado 3 o 4 sigue la onda de cerca. Con grado 12 o 15 pasa casi exactamente por cada punto, serpenteando entre ellos, y en los huecos entre puntos se dispara hacia donde ningún dato lo respalda.

Interactivo Puntos con ruido tomados de una onda, y el polinomio de grado elegido que mejor los ajusta. A la derecha, el error sobre esos mismos puntos (negro) y sobre doscientos puntos nuevos de la misma onda (naranja), para cada grado. Sube el grado hasta el número de puntos y pide otra muestra: la curva que pasa por todos los puntos cambia por completo.

La gráfica de la derecha es la que importa, y es la que el que entrena un modelo no puede ver sin más datos. La línea negra es el error sobre los puntos de entrenamiento (training data); baja siempre al subir el grado, porque un polinomio más flexible siempre puede acercarse más a unos puntos dados, y con grado igual al número de puntos menos uno pasa exactamente por todos y el error es cero. La línea naranja es el error sobre doscientos puntos nuevos de la misma onda, que el polinomio nunca vio. Baja al principio, cuando el modelo gana la flexibilidad que la onda necesita, y vuelve a subir cuando la gana de más y la gasta en seguir el ruido. El mínimo de esa curva es el grado correcto, y está muy lejos del que minimiza la línea negra. El botón que pide otra muestra enseña lo mismo desde otro ángulo: el polinomio de grado alto cambia de forma entera con cada muestra, mientras que el de grado bajo apenas se mueve.

Esa es la descomposición que Stuart Geman, Elie Bienenstock y René Doursat formularon en 1992 con el nombre de dilema sesgo-varianza. El error de un modelo sobre datos nuevos tiene dos fuentes. El sesgo es lo que se equivoca sistemáticamente por ser demasiado simple para la realidad, la recta que no puede ondular. La varianza es lo que se equivoca por depender demasiado de la muestra concreta, el polinomio de grado quince que sería otro con otros veinte puntos. Aumentar la flexibilidad reduce el sesgo y aumenta la varianza, y el mejor modelo es el que equilibra ambos. El ruido, que el segundo deslizador controla, decide dónde está ese equilibrio: con datos limpios se puede permitir un modelo más flexible; con datos ruidosos, la flexibilidad es más peligrosa. Y el número de puntos también: con más datos, la varianza baja y el grado óptimo sube.

El problema tiene una solución de método, no de fórmula, y es de las más importantes de la estadística aplicada: no evaluar nunca el modelo con los datos que lo entrenaron. Mervyn Stone formalizó en 1974 la validación cruzada (cross-validation), que consiste en apartar una parte de los datos, ajustar el modelo con el resto, medir el error en la parte apartada, y repetirlo rotando la parte apartada para usar todos los datos sin hacer trampa. Es lo que hace la figura al medir la línea naranja sobre puntos nuevos. La alternativa de Hirotugu Akaike, del mismo año, es penalizar la flexibilidad directamente: su criterio suma al error de entrenamiento un castigo proporcional al número de parámetros, y elige el modelo que minimiza la suma. Las técnicas de regularización (regularization) que usan las redes neuronales —penalizar pesos grandes, apagar neuronas al azar durante el entrenamiento, detener el entrenamiento cuando el error de validación deja de bajar— son variantes de la misma idea: limitar la flexibilidad para que no la gaste en el ruido.

Hay una coda reciente que conviene conocer, porque complica el cuadro sin desmentirlo. Mikhail Belkin y sus colegas mostraron en 2019 que, en muchos modelos modernos, si se sigue aumentando la flexibilidad mucho más allá del punto en que el modelo pasa exactamente por todos los datos, el error de prueba vuelve a bajar: la curva naranja tiene un segundo descenso. Las redes neuronales con muchos más parámetros que ejemplos, que según el dilema clásico deberían sobreajustar sin remedio, generalizan bien en la práctica, y por qué lo hacen es una pregunta abierta. La lección de la figura sigue siendo válida en la zona que muestra, la de los modelos que caben en un deslizador de quince posiciones: el error que se puede medir mientras se entrena no es el error que importa, y un modelo que acierta todo lo que ha visto es sospechoso, no admirable.

El árbol de decisión – La alineación de la inteligencia artificial – La red neuronal – El descenso de gradiente

Capítulo 5 de 13

El árbol de decisión

Informática 1064 palabras artículo suelto ↗

Un árbol de decisión (en inglés, decision tree) es un modelo que clasifica haciendo preguntas de sí o no, una detrás de otra, como un médico de urgencias que decide a quién atender primero o como el juego de adivinar un personaje. Cada pregunta mira un solo dato y lo compara con un umbral (threshold): ¿tiene la tensión por debajo de 91?, ¿más de 62 años? Según la respuesta se baja por una rama (branch) o por otra hasta llegar a una hoja (leaf), que da el veredicto. Lo que tiene de aprendizaje automático es que nadie escribe las preguntas: el algoritmo las elige mirando ejemplos ya clasificados, y la manera en que lo hace explica a la vez su éxito y su defecto principal.

La figura de esta página entrena uno delante del lector. Los puntos son ejemplos de dos clases, azul y naranja, repartidos por un plano según dos datos, x e y. Cada pregunta del árbol corta el plano con una línea recta paralela a uno de los ejes, y cada hoja es un rectángulo pintado del color que el árbol predice para todo lo que caiga dentro. Con profundidad cero no hay ninguna pregunta y el árbol responde siempre la clase más frecuente; con uno, parte el plano en dos; con tres, en ocho rectángulos como mucho. A la derecha, las primeras preguntas aparecen escritas, y la gráfica mide cuántos puntos acierta el árbol según la profundidad, con dos curvas que conviene mirar juntas.

Interactivo Sube la profundidad y mira cómo el árbol parte el plano en rectángulos cada vez más pequeños. La curva negra mide los aciertos sobre los doscientos puntos con que se entrenó; la naranja, sobre cuatrocientos que no vio. Cambia de datos, sube el ruido y pulsa «Ver los datos de prueba» para mirar lo que el árbol no conocía.

El algoritmo elige cada pregunta por fuerza bruta y sin mirar adelante. Prueba todos los cortes posibles en los dos ejes, entre cada par de puntos consecutivos, y se queda con el que deja los dos lados más puros, es decir, más cerca de tener una sola clase. La medida de pureza de la figura es el índice de Gini (Gini impurity), la probabilidad de equivocarse si se etiqueta un punto al azar según las proporciones del grupo: vale cero en un grupo de un solo color y 0,5 en uno mitad y mitad. Una vez elegido el corte, el algoritmo repite lo mismo en cada mitad por separado, y así hasta que los grupos son puros o se alcanza la profundidad fijada. Encontrar el mejor árbol posible, el que acierta más con menos preguntas, es un problema intratable: Laurent Hyafil y Ronald Rivest demostraron en 1976 que pertenece a la familia de los NP-completos, para los que no se conoce un método eficiente. Por eso todos los algoritmos prácticos son voraces y deciden cada pregunta como si fuera la última.

El conjunto llamado tablero enseña lo que cuesta esa miopía. Los naranjas están en dos cuadrantes opuestos y los azules en los otros dos, de modo que ninguna pregunta sola, sobre x o sobre y, mejora nada: cada mitad sigue siendo mitad y mitad. El árbol voraz elige un primer corte casi al azar, empujado por el ruido de la muestra, y es la segunda pregunta la que ordena el plano. El conjunto de la frontera diagonal enseña el otro límite: una recta inclinada, que un modelo lineal como el perceptrón traza de una vez, el árbol solo puede imitarla con una escalera de rectángulos, más fina cuanto más profundo es.

Y en la profundidad está el problema. La curva negra de la figura, la de los puntos de entrenamiento, sube siempre: con suficientes preguntas, el árbol puede aislar cada punto en su propio rectángulo y acertarlos todos, incluidos los que el ruido cambió de color. La curva naranja, que mide los aciertos sobre cuatrocientos puntos que el árbol no ha visto, sube al principio, llega a un máximo y después baja o se estanca, porque los rectángulos diminutos dibujados alrededor de puntos ruidosos no dicen nada sobre los puntos nuevos. La distancia entre las dos curvas es el sobreajuste, y en un árbol de decisión es especialmente fácil de ver, porque cada error de más es un rectángulo que se puede señalar. Subir el ruido de la figura separa las curvas antes.

El árbol nació en la estadística de encuestas. James Morgan y John Sonquist, del Centro de Investigación de Encuestas de la Universidad de Michigan, propusieron en 1963 un procedimiento que llamaron AID, detección automática de interacciones, para partir a los encuestados en grupos cada vez más homogéneos según su renta o su consumo, en lugar de ajustar una ecuación con todas las variables a la vez. Veinte años después, cuatro estadísticos californianos, Leo Breiman, Jerome Friedman, Richard Olshen y Charles Stone, publicaron Classification and Regression Trees, el libro que dio al método sus reglas: el índice de Gini, la poda (pruning), que deja crecer el árbol entero y después corta las ramas que no mejoran sobre datos separados, y el nombre CART con que aún se conoce. El libro abre con un ejemplo médico: pacientes ingresados por un infarto, a los que tres preguntas sobre la tensión mínima, la edad y el ritmo cardiaco bastaban para separar a los de alto riesgo. En 1986, el australiano Ross Quinlan publicó ID3, que medía la pureza con la entropía de la teoría de la información y que dio lugar a una familia paralela de algoritmos.

Lo que convirtió al árbol en una de las herramientas más usadas del aprendizaje automático fue renunciar a su mejor cualidad. Un árbol solo, con sus pocas preguntas legibles, se puede explicar a un médico o a un juez, pero es inestable: una muestra un poco distinta da un primer corte distinto y un árbol entero diferente. Leo Breiman propuso en 2001 los bosques aleatorios (random forests): cientos de árboles profundos, cada uno entrenado con una muestra distinta de los datos y obligado a elegir cada pregunta entre unas pocas variables sorteadas, que votan el resultado. Cada árbol sobreajusta a su manera, y los errores, al no coincidir, se compensan. Las variantes que añaden árboles uno a uno para corregir los errores de los anteriores, el llamado gradient boosting, suelen ser hoy lo que mejor funciona con datos en forma de tabla, como los de un banco o un hospital, por encima de las redes neuronales que dominan con imágenes y texto. Se paga en legibilidad: un bosque de quinientos árboles ya no se puede leer, y la ventaja del modelo que hacía preguntas que cualquiera entendía se queda en cada uno de sus árboles por separado.

El algoritmo de k-medias

Capítulo 6 de 13

El algoritmo de k-medias

Informática 842 palabras artículo suelto ↗

El algoritmo de k-medias (en inglés, k-means clustering) reparte un conjunto de puntos en k grupos de manera que cada punto quede lo más cerca posible del centro de su grupo. Es el procedimiento más usado del aprendizaje no supervisado (unsupervised learning), la rama del aprendizaje automático (machine learning) que trabaja con datos sin etiquetas: nadie dice al algoritmo qué grupos hay ni cuáles son, solo cuántos debe encontrar. Se usa para segmentar clientes, comprimir imágenes reduciendo sus colores a unos pocos, agrupar documentos por tema y, como paso previo, para resumir millones de puntos en unos cientos de representantes. Es simple, rápido y casi siempre lo primero que se prueba, y por eso conviene entender bien qué hace y en qué se equivoca.

El algoritmo alterna dos pasos que la figura de esta página ejecuta uno a uno. Primero, asignación: cada punto se une al centro más cercano y toma su color. Segundo, actualización: cada centro se desplaza a la posición media de los puntos que se le han unido. Se repite hasta que ningún centro se mueve. Cada paso reduce, o deja igual, una cantidad que se llama inercia: la suma de las distancias al cuadrado de cada punto a su centro. Como la inercia no puede bajar indefinidamente, el proceso termina siempre, y casi siempre en pocas rondas. La figura muestra la inercia en cada paso y, a la derecha, la inercia final que se obtiene con cada valor de k entre uno y ocho.

Interactivo Puntos y k centros (las cruces). Cada paso alterna asignar los puntos al centro más cercano y mover los centros a la media de los suyos. Pulsa «Otros centros» varias veces con los cinco grupos desiguales: el resultado depende de dónde empiece. El anillo y los datos uniformes muestran los dos fallos clásicos. La gráfica del codo sirve para elegir k.

La primera cosa que la figura enseña es que el resultado depende de la posición inicial de los centros. El algoritmo garantiza llegar a un mínimo de la inercia, pero local: si dos centros caen dentro del mismo grupo natural y un tercero queda a medio camino entre otros dos, ese reparto puede ser estable y ningún paso lo arregla. Con el conjunto de cinco grupos desiguales basta pulsar «Otros centros» unas veces para ver soluciones distintas con inercias distintas. La respuesta práctica es ejecutar el algoritmo varias veces desde puntos distintos y quedarse con la mejor; la respuesta elegante la dieron David Arthur y Sergei Vassilvitskii en 2007 con k-means++, que elige los centros iniciales uno a uno con probabilidad proporcional al cuadrado de la distancia a los ya elegidos, de modo que empiezan separados, y demostraron que eso garantiza en promedio una inercia a lo sumo unas pocas veces mayor que la óptima. El botón de la figura lo activa y las malas salidas se vuelven raras.

La segunda cosa es que k hay que elegirlo, y el algoritmo no ayuda. La inercia baja siempre al aumentar k, porque más centros están más cerca de todo, hasta llegar a cero cuando hay un centro por punto. La gráfica de la derecha, la curva del codo, muestra ese descenso; la heurística consiste en buscar el punto donde deja de bajar deprisa, el codo, y tomar ese k. Con tres grupos claros el codo está en tres y se ve bien. Con los cinco grupos desiguales está en cinco pero menos marcado. Con los datos uniformes no hay codo, la curva baja suavemente, y esa ausencia es la señal: no hay grupos que encontrar. Y sin embargo el algoritmo devuelve k grupos igual, con colores nítidos y fronteras rectas. K-medias siempre encuentra grupos, existan o no, y esa es la razón principal para desconfiar de un resultado que no se ha contrastado.

La tercera cosa es la forma. K-medias asigna cada punto al centro más cercano, y eso parte el plano en regiones convexas separadas por rectas, las celdas de Voronoi de los centros. Solo puede encontrar grupos redondos, o al menos convexos, y de tamaños parecidos. El conjunto del anillo con un punto en el centro lo muestra: un ser humano ve dos grupos, el anillo y el centro, y k-medias con k = 2 parte el anillo por la mitad y mete el centro con una de las mitades. Para grupos con esa forma hacen falta otros métodos, como el agrupamiento espectral o el basado en densidad, que definen la cercanía por cadenas de vecinos y no por la distancia a un centro.

El algoritmo tiene tantos padres como usos. Hugo Steinhaus lo planteó en 1956 como el problema de dividir un cuerpo en partes; Stuart Lloyd lo describió en 1957 en un informe interno de los Laboratorios Bell para cuantizar señales, que no se publicó hasta 1982; Edward Forgy lo publicó en 1965; y James MacQueen le puso el nombre en 1967 y propuso la versión que actualiza el centro después de cada punto en lugar de después de todos. Que se inventara varias veces dice algo de su naturalidad: es la primera idea que se le ocurre a cualquiera que quiera agrupar puntos, y por eso su lección más útil es la de la figura, que esa primera idea tiene condiciones, y que los grupos que devuelve son tan buenos como las suposiciones que uno hizo al elegir k y al aceptar que sean redondos.

El árbol de decisión

Capítulo 7 de 13

El problema del falso positivo

Matemática y estadística 992 palabras artículo suelto ↗

El problema del falso positivo es la discrepancia, casi siempre enorme, entre lo fiable que parece una prueba diagnóstica y lo que de verdad significa dar positivo en ella. Una prueba que acierta el 90 % de las veces en los enfermos y el 91 % de las veces en los sanos suena excelente; aplicada a una enfermedad que afecta al 1 % de la población, quien recibe un positivo tiene solo un 9 % de probabilidades de estar enfermo. El cálculo que lo demuestra es el teorema de Bayes, y el hecho de que casi nadie —médicos incluidos— lo haga bien es uno de los resultados más replicados de la psicología del razonamiento.

El mecanismo se entiende mejor contando personas que multiplicando probabilidades, y eso es lo que hace la figura. De mil personas, diez están enfermas y novecientas noventa no. La prueba detecta a nueve de los diez enfermos: esos son los positivos verdaderos, en naranja. Pero también da positivo, por error, al 9 % de los sanos, que son ochenta y nueve personas más, en naranja claro. Quien recibe un positivo pertenece a ese grupo de noventa y ocho, y solo nueve de ellos están enfermos. El botón de la figura que deja en pantalla solo a los positivos muestra la proporción sin necesidad de cálculo: una franja naranja pequeña dentro de un bloque grande de falsas alarmas.

Interactivo Mil personas —o diez mil— clasificadas por si están enfermas y por lo que dice la prueba. Mueve la prevalencia y mira cómo cambia lo que vale un positivo aunque la prueba no cambie. Los casos preconfigurados usan cifras publicadas; «Ajuste libre» deja tocar las tres.

La palanca que gobierna el resultado no es la calidad de la prueba, sino la rareza de lo que busca. En la figura, con la sensibilidad y la especificidad fijas, bajar la prevalencia del 1 % al 0,1 % hace que la probabilidad de estar enfermo tras un positivo caiga del 9 % a menos del 1 %: de cada cien positivos, noventa y nueve son falsas alarmas. Subirla al 20 %, que es lo que ocurre cuando la prueba se aplica solo a personas con síntomas, la eleva por encima del 70 %. Es la misma prueba. Lo que cambia es a quién se le hace, y por eso la misma tecnología es razonable como herramienta de confirmación en una consulta y discutible como cribado universal.

Que este razonamiento no es natural está medido desde hace décadas. En 1978 Ward Casscells y sus colegas plantearon a sesenta médicos y estudiantes de la Facultad de Medicina de Harvard un problema con una prevalencia de uno entre mil y una tasa de falsos positivos del 5 %, y les pidieron la probabilidad de que un positivo estuviera enfermo. La respuesta correcta es aproximadamente el 2 %. Once de los sesenta la dieron; la respuesta más frecuente fue 95 %, que es simplemente cien menos la tasa de falsos positivos, es decir, ignorar la prevalencia por completo. David Eddy documentó en 1982 el mismo patrón entre médicos que interpretaban mamografías: estimaban en un 75 % la probabilidad de cáncer tras una mamografía positiva cuando la cifra real, con las estadísticas de la época, rondaba el 8 %.

Gerd Gigerenzer y Ulrich Hoffrage demostraron en 1995 que el fallo está en el formato, no en las personas. Cuando el mismo problema se plantea con probabilidades —«la prevalencia es del 1 %, la sensibilidad del 90 %, la tasa de falsos positivos del 9 %»—, alrededor del 16 % de los participantes llega al resultado correcto. Cuando se plantea con lo que llamaron frecuencias naturales —«de cada mil mujeres, diez tienen la enfermedad; de esas diez, nueve dan positivo; de las novecientas noventa sanas, unas ochenta y nueve dan positivo también»—, la proporción de aciertos sube al 46 %, sin ninguna formación previa. En 2000, con Samuel Lindsey y Ralph Hertwig, repitieron el experimento con médicos en ejercicio y con estudiantes de derecho evaluando pruebas de ADN, con resultados equivalentes: el formato de frecuencias multiplicó por cuatro los aciertos. La figura de esta página es una frecuencia natural dibujada.

La razón de que las frecuencias funcionen es que hacen visible el denominador. La pregunta «¿qué probabilidad tiene de estar enfermo quien da positivo?» exige saber cuántos positivos hay en total, y esa cifra depende del tamaño del grupo de sanos, que las probabilidades condicionales esconden. Una tasa de falsos positivos del 9 % parece pequeña; ochenta y nueve personas en una sala de mil no lo parece tanto, y noventa y ocho positivos de los que nueve están enfermos es una imagen que no requiere fórmula. El teorema de Bayes, escrito, dice lo mismo: la probabilidad de la enfermedad dado el positivo es la de un positivo verdadero dividida por la de cualquier positivo, verdadero o falso. La rejilla simplemente cuenta las dos cosas.

Las consecuencias prácticas son de política sanitaria y no solo de aula. Un programa de cribado poblacional para una enfermedad rara produce, por construcción, muchos más falsos positivos que casos reales, y cada falso positivo arrastra pruebas de confirmación, a veces invasivas, y semanas de angustia. Esto no hace que el cribado sea malo: hace que la decisión de implantarlo dependa de una comparación entre daños evitados y daños causados, y esa comparación solo se puede hacer si quien decide entiende la figura de esta página. Gigerenzer ha sostenido durante veinte años que enseñar a leer resultados diagnósticos en frecuencias naturales debería ser parte de la alfabetización básica, y que gran parte de lo que se presenta como un problema de comunicación médico-paciente es un problema de formato numérico que tiene solución conocida.

El caso de la prueba del VIH, uno de los preconfigurados en la figura, es el más extremo y el más instructivo. La prueba es extraordinariamente buena: detecta al 99,9 % de los infectados y da negativo al 99,9 % de los sanos. Aplicada en una población donde la infección afecta a una de cada mil personas, la mitad de los positivos son falsos. Aplicada a un grupo de alto riesgo donde afecta a una de cada diez, más del 99 % son verdaderos. Ninguna cifra sobre la prueba, por sí sola, dice cuál de las dos situaciones es la del paciente que tiene delante el resultado en la mano.

La curva ROC – El problema de Monty Hall

Capítulo 8 de 13

La curva ROC

Matemática y estadística 930 palabras artículo suelto ↗

La curva ROC es la gráfica que resume cómo se comporta una prueba o un clasificador cuando se mueve el umbral a partir del cual dice «sí». Para cada umbral posible se anotan dos números: qué fracción de los casos positivos detecta, la sensibilidad, y qué fracción de los negativos marca por error, la tasa de falsos positivos. Unidos, esos puntos forman una curva que sube desde la esquina inferior izquierda, donde la prueba no dice sí a nadie, hasta la superior derecha, donde se lo dice a todos. Cuanto más se pega la curva a la esquina superior izquierda, mejor distingue la prueba; una prueba que no distingue nada dibuja la diagonal. Las siglas vienen de receiver operating characteristic, la característica de funcionamiento del receptor, y delatan su origen: la teoría de detección de señales de los operadores de radar de los años cincuenta.

La figura de esta página construye la curva desde su origen. A la izquierda, dos campanas: la distribución de la puntuación que da una prueba en las personas sanas, en negro, y en las enfermas, en naranja. Ninguna prueba real separa por completo las dos; el deslizador de separación mide cuánto se alejan, y con separación cero son la misma campana. El umbral es la raya vertical, y se puede arrastrar. Todo lo que queda a su derecha se declara positivo: los enfermos que están ahí son verdaderos positivos y los sanos, falsos positivos; los enfermos que quedan a la izquierda son falsos negativos, los que la prueba pasa por alto. La tabla de debajo cuenta los cuatro grupos sobre diez mil personas, y el punto negro de la derecha es el umbral actual situado sobre la curva ROC.

Interactivo Puntuaciones de una prueba en sanos (negro) y enfermos (naranja), el umbral que se puede arrastrar, la matriz de confusión sobre diez mil personas y la curva ROC con el punto correspondiente. Mueve la separación para ver la curva pegarse a la esquina o caer sobre la diagonal; cambia la prevalencia y mira lo que le pasa al valor de un positivo sin que la curva se mueva.

Lo que la figura enseña primero es que la sensibilidad y la especificidad no son dos virtudes de la prueba sino dos extremos de una cuerda. Arrastrar el umbral a la izquierda detecta más enfermos y asusta a más sanos; a la derecha, lo contrario. Los dos botones de la figura sitúan el umbral donde la sensibilidad es del 95 % y donde lo es la especificidad, y la tabla cuenta el precio de cada elección. No hay un umbral correcto: depende de lo que cueste cada tipo de error. Para una prueba de cribado, que se seguirá de otra más precisa, se prefiere perder pocos enfermos aunque haya muchas falsas alarmas; para una decisión irreversible, lo contrario. La curva ROC muestra todas las opciones a la vez, y por eso se usa para comparar pruebas sin comprometerse con un umbral.

La segunda lección está en el área bajo la curva, el número que la figura escribe en la esquina. El AUC vale 1 para una prueba perfecta y 0,5 para una inútil, y tiene una interpretación exacta que James Hanley y Barbara McNeil demostraron en 1982: es la probabilidad de que, tomados al azar un enfermo y un sano, la prueba puntúe más alto al enfermo. Con las campanas de la figura, depende solo de la separación: 0,76 para una separación de 1, 0,92 para una de 2. Es la medida estándar de lo que un clasificador puede hacer, con independencia de dónde se ponga el umbral, y lo que se reporta cuando se compara un modelo con otro. John Swets defendió en 1988 en Science que se adoptara en toda la medicina diagnóstica, en la meteorología y en la evaluación de pruebas psicológicas, campos donde hasta entonces cada uno medía la exactitud como podía.

La tercera lección es la que la curva no cuenta, y para verla hay que mover el deslizador de la prevalencia. Ni la curva ROC ni el AUC cambian con ella: dependen solo de las dos campanas. Pero el valor de un resultado positivo, la fracción de los positivos que están de verdad enfermos, cambia por completo. Con una prevalencia del 10 % y un umbral razonable, la mayoría de los positivos son enfermos; con una del 1 %, la misma prueba con el mismo umbral produce muchas más falsas alarmas que aciertos, porque hay cien sanos por cada enfermo y basta que unos pocos de cada cien crucen el umbral para que superen a los enfermos. Es el problema del falso positivo que tiene su propio artículo en esta enciclopedia, visto desde la prueba en lugar de desde el paciente. Takaya Saito y Marc Rehmsmeier argumentaron en 2015 que, cuando la clase positiva es rara —fraude, enfermedades poco frecuentes, fallos de una máquina—, la curva ROC engaña por su optimismo y conviene mirar la curva de precisión frente a sensibilidad, que sí depende de la prevalencia y que castiga los falsos positivos en proporción a lo que cuestan.

El origen de la curva explica su nombre y su forma de pensar. Peterson, Birdsall y Fox la formularon en 1954 para el radar: un operador que mira una pantalla con ruido tiene que decidir si un parpadeo es un avión, y puede ser más o menos propenso a decir que sí; la curva separa lo que depende del aparato, la distancia entre las campanas, de lo que depende del criterio del operador, el umbral. David Green y John Swets la llevaron en 1966 a la psicología de la percepción con el mismo argumento: que alguien detecte un sonido débil depende tanto de su oído como de su disposición a arriesgar una falsa alarma, y sin la curva las dos cosas se confunden. Esa separación entre capacidad y criterio es lo que la figura permite tocar: el deslizador de separación mueve la curva, el umbral solo recorre un punto sobre ella.

El problema del falso positivo

Capítulo 9 de 13

La ley de Zipf

Lingüística 945 palabras artículo suelto ↗

La ley de Zipf afirma que, en cualquier texto suficientemente largo, la frecuencia de una palabra es inversamente proporcional a su posición en la lista de palabras ordenadas de más a menos frecuente. La segunda palabra más común aparece la mitad de veces que la primera; la décima, una décima parte; la centésima, una centésima parte. Es una regularidad estadística, no una regla gramatical: la cumplen el inglés y el chino, el latín y el euskera, los textos de un solo autor y los corpus de millones de páginas, y la cumplen con un ajuste tan bueno que durante décadas se ha buscado en ella una clave del funcionamiento del lenguaje.

La figura de esta página no usa un corpus ajeno sino el propio: los más de cuatro mil artículos de Ikusmira, unas 760.000 palabras en el momento de escribir esto, de las que 42.000 son distintas. La palabra más frecuente es «de», con más de 47.000 apariciones, seguida de «la», «que», «y» y «el». Las diez primeras son casi el 29 % de todo el texto; las cien primeras, la mitad; las mil primeras, el 70 %. Y casi la mitad de las palabras distintas del corpus aparece exactamente una vez. Con los ejes en escala logarítmica, la nube de puntos es prácticamente una recta, y su pendiente es el exponente de la ley: para este corpus, alrededor de 0,93, muy cerca del 1 que Zipf propuso.

Interactivo Cada punto es una palabra del corpus de Ikusmira, situada por su rango y por las veces que aparece en cada millón de palabras. La línea naranja es la ley de Zipf con el exponente del deslizador. Pasa el dedo por los puntos para leer la palabra; elige un estante para superponer su curva; pega un texto propio y verás la suya. El botón de los ejes muestra cómo se ve la misma nube sin logaritmos.

El fenómeno lo observó primero el estenógrafo francés Jean-Baptiste Estoup, que hacia 1916 contaba palabras para decidir qué abreviaturas convenía enseñar, y lo estudió con detalle el lingüista estadounidense George Kingsley Zipf en dos libros, de 1935 y 1949. Zipf contó a mano las palabras del Ulises de Joyce, de textos en latín y en chino y de periódicos, y encontró la misma proporción en todos. Su explicación fue el principio del mínimo esfuerzo: el hablante preferiría un vocabulario pequeño de palabras muy generales, que le ahorra trabajo al hablar; el oyente preferiría un vocabulario grande de palabras muy precisas, que le ahorra trabajo al entender; la ley sería el equilibrio entre las dos fuerzas. Ramon Ferrer i Cancho y Ricard Solé formalizaron esa intuición en 2003 con un modelo en el que el exponente de Zipf aparece justo en la transición entre un lenguaje de una sola palabra y uno de infinitas.

El problema de esa explicación, y de la mayoría de las que la han seguido, es que la ley es demasiado fácil de obtener. Herbert Simon mostró en 1955 que un proceso muy simple la produce: si cada nueva palabra de un texto se elige con una probabilidad proporcional a las veces que ya ha aparecido, más una pequeña probabilidad de ser una palabra nueva, la distribución resultante sigue la ley de Zipf. Es el mismo mecanismo de «los ricos se hacen más ricos» que explica el tamaño de las ciudades o el número de citas de los artículos científicos, y no dice nada específico del lenguaje. Peor aún: Wentian Li demostró en 1992 que un mono que teclease al azar, con una tecla para el espacio, produciría «palabras» cuyas frecuencias también obedecen la ley. Si un texto sin significado la cumple, la ley no puede ser una pista sobre el significado.

La revisión de Steven Piantadosi de 2014 pone orden en la discusión y llega a dos conclusiones. La primera es que la ley se cumple, pero no exactamente: la fórmula de Zipf falla sistemáticamente en las palabras más frecuentes, que aparecen menos de lo que predice, y en las muy raras, y la corrección que propuso Benoît Mandelbrot en los años cincuenta —desplazar el rango una constante— ajusta mejor. La segunda es que la ley por sí sola no permite decidir entre explicaciones, porque muchas la generan; lo que permite discriminar entre ellas son otros hechos, como que la misma palabra tenga frecuencias parecidas en textos muy distintos o que las palabras más frecuentes tiendan a ser las más cortas, otra regularidad que también lleva el nombre de Zipf.

El selector de estantes de la figura enseña algo de eso. Un estante de Ikusmira —Literatura, Historia, Economía— es un corpus más pequeño y más homogéneo que el conjunto, y su curva se separa de la general en las palabras del oficio: en Economía, «capital», «producción» y «precios» suben más de cien puestos respecto al conjunto; en Historia lo hacen «régimen», «guerra» y «gobierno». Las cien palabras más frecuentes, en cambio, son casi las mismas en todos, porque son artículos, preposiciones y conjunciones, y la ley las gobierna igual. Un texto pegado en la caja de la figura, si es corto, hace algo distinto: su curva cae por debajo de la general, porque con pocas palabras el vocabulario no ha tenido ocasión de repetirse, y la proporción de palabras que aparecen una sola vez es enorme. La ley necesita longitud para manifestarse.

Lo que la ley sí tiene de útil es práctico y se usa a diario. Es la razón de que los buscadores y los correctores puedan descartar las palabras vacías sin perder casi nada, de que aprender las mil palabras más frecuentes de una lengua permita entender la mayor parte de cualquier texto y, al mismo tiempo, casi ninguno por completo, y de que cualquier corpus, por grande que sea, contenga miles de palabras vistas una sola vez, para las que un modelo del lenguaje no tiene experiencia. El corpus de esta enciclopedia tiene diecinueve mil de esas palabras, y crecerá con cada artículo que se añada sin que la proporción baje mucho. Es la parte de la ley de Zipf que ninguna explicación ha conseguido hacer desaparecer.

La distribución de Pareto – La ley de Benford

Capítulo 10 de 13

El modelo de lenguaje de n-gramas

Informática 942 palabras artículo suelto ↗

Un modelo de lenguaje (en inglés, language model) es una función que asigna a cada palabra una probabilidad de aparecer a continuación de las anteriores. Es la pieza que hay detrás del corrector del teléfono, del reconocedor de voz (speech recognizer) que elige entre dos frases que suenan igual, y de los sistemas actuales de inteligencia artificial que generan texto, que en el fondo hacen lo mismo que la figura de esta página: mirar lo escrito hasta ahora, calcular qué palabra es probable que siga, elegir una y volver a empezar. La diferencia entre el modelo de esta figura y uno moderno está en cuánto contexto mira y en cómo calcula la probabilidad, no en el gesto. Por eso vale la pena ver el gesto en su forma más simple.

El modelo de la figura es de bigramas (bigrams): solo mira la última palabra. Está entrenado con el propio corpus de Ikusmira, casi treinta y seis mil oraciones, y consiste en una tabla que dice, para cada una de las mil quinientas palabras más frecuentes, con qué palabra siguió el texto y cuántas veces. Después de «la», la palabra que más veces vino a continuación en esta enciclopedia fue «que», y luego «empresa», «distribución», «media» y «sociedad»; después de «sistema», «de», «político» y «educativo». Esas frecuencias, divididas por el total, son las probabilidades, y son las barras claras de la figura. Generar texto es recorrer la tabla: se empieza con la distribución de las palabras que abren oración, se elige una, se busca su fila, se elige la siguiente, y así hasta que sale el punto, que también es una palabra de la tabla.

Interactivo Un modelo de bigramas entrenado con las oraciones de esta enciclopedia. Las barras son las palabras que siguieron a la última en el corpus, con su frecuencia; pulsa una para elegirla o deja que el modelo sortee. La temperatura decide cuánto se fía de la barra más larga. Escribe una palabra para empezar por ella.

Lo que se ve al escribir veinte palabras es exactamente lo que se espera de un modelo que solo recuerda una: cada par de palabras consecutivas es plausible, porque salió del corpus, y la frase entera no lo es, porque nadie ha comprobado que la cuarta palabra tenga algo que ver con la primera. El texto cambia de tema a mitad de la oración y produce concordancias imposibles, y sin embargo suena a esta enciclopedia, con su «la distribución de la» y su «el sistema político de». Andréi Márkov hizo el primer análisis de este tipo en 1913, contando a mano las vocales y consonantes de los veinte mil primeros caracteres de Eugenio Oneguin para mostrar que la probabilidad de cada letra dependía de la anterior, y las cadenas que llevan su nombre son la matemática del asunto. Claude Shannon convirtió esa idea en un modelo del lenguaje en 1948: en el artículo que fundó la teoría de la información generó textos en inglés con modelos de orden creciente, de letras y luego de palabras, y mostró que con bigramas de palabras ya aparecen tramos que parecen inglés, y con trigramas, frases casi enteras. En 1951 usó el mismo instrumento al revés, pidiendo a personas que adivinaran la letra siguiente de un texto, para estimar cuánta información lleva cada letra del inglés.

El deslizador de temperatura (temperature) enseña la segunda idea importante, que es cómo se elige. Si el modelo tomara siempre la palabra más probable, escribiría siempre lo mismo y caería en bucles: «de la de la de la». Si sorteara con las probabilidades tal cual, produciría rarezas cada pocas palabras. La temperatura reparte entre los dos extremos: baja, acentúa las diferencias entre las barras y el modelo se vuelve conservador y repetitivo; alta, las iguala y el modelo se vuelve variado y disparatado. El mismo parámetro, con el mismo nombre, existe en los sistemas generativos actuales, y la experiencia de mover el deslizador de la figura es la misma que tiene quien lo ajusta en uno de ellos.

El problema que impidió que los n-gramas (n-grams) fueran más lejos es el que se ve al escribir una palabra que la figura no conoce: la tabla no tiene fila para ella. Un modelo de bigramas con un vocabulario de cincuenta mil palabras tiene dos mil quinientos millones de pares posibles, y casi todos no aparecen nunca en ningún corpus; uno de trigramas tiene muchos más, y las combinaciones no vistas dominan. Slava Katz propuso en 1987 el remedio estándar, el retroceso: si el trigrama no se ha visto, usar el bigrama, y si tampoco, la palabra sola, descontando algo de probabilidad a lo visto para dárselo a lo no visto. Con esos parches, los modelos de n-gramas fueron el corazón del reconocimiento de voz y la traducción automática durante treinta años, y el manual de Jurafsky y Martin sigue dedicándoles un capítulo porque las ideas —la probabilidad condicional, el vocabulario cerrado, el suavizado (smoothing), la perplejidad como medida— son las mismas que después.

Lo que cambió fue la representación. Yoshua Bengio y sus colegas propusieron en 2003 sustituir la tabla por una red neuronal que aprendiera, para cada palabra, un vector de números en el que palabras parecidas quedan cerca, de modo que lo que el modelo aprende sobre «empresa» le sirve también para «compañía», que en la tabla de bigramas es una fila aparte. Los modelos actuales son descendientes de esa idea, con una diferencia de escala que lo cambia todo: miran miles de palabras de contexto en lugar de una, y sus tablas son redes con cientos de miles de millones de pesos entrenadas sobre billones de palabras. Pero al final de cada paso hacen lo que hace la figura: producir una distribución sobre la palabra siguiente y elegir una. Cuando la figura escribe «la sociedad de la información y la comunicación de la empresa» está haciendo, con una memoria de una palabra, lo mismo que hacen ellos con una de miles.

Jev, el modelo que no escribe

Capítulo 11 de 13

Jev, el modelo que no escribe

Informática 1332 palabras artículo suelto ↗

Jev es un modelo de inteligencia artificial (en inglés, artificial intelligence model) que entiende el lenguaje humano pero no lo escribe. Se le da un texto, un correo de un cliente, un contrato o la descripción de una partida, y una serie de preguntas cerradas (closed-ended questions) sobre él, y devuelve para cada una la respuesta elegida entre las que se le ofrecieron, con la probabilidad de cada alternativa. No redacta, no explica y no conversa. Lo presentó el 15 de septiembre de 2026 TypeSafe AI, una empresa de San Francisco fundada en 2024 por Diogo Almeida, Erik Gafni y Sasha Sheng, junto con una ronda de cuarenta millones de dólares encabezada por el fondo DCVC. Almeida trabajó cuatro años en OpenAI y firma el artículo de 2022 sobre InstructGPT, el método de entrenamiento con valoraciones humanas que convirtió a los modelos de lenguaje en asistentes de conversación. Jev es, en cierto modo, su enmienda.

TypeSafe llama a Jev un modelo System One, por la distinción que popularizó el psicólogo Daniel Kahneman en Pensar rápido, pensar despacio: el sistema 1 es el juicio rápido e intuitivo, el que decide sin pensarlo si una cara está enfadada, y el sistema 2, el razonamiento lento y deliberado. Los grandes modelos de lenguaje han ido hacia el segundo, con cadenas de razonamiento que pueden tardar minutos. Jev va hacia el primero. El nombre, en cambio, es de economista: viene de William Stanley Jevons, el de la paradoja de Jevons, que observó en 1865 que las máquinas de vapor más eficientes no redujeron el consumo de carbón sino que lo multiplicaron. La apuesta de la empresa es que con la inteligencia artificial barata ocurrirá lo mismo.

La manera de usarlo se parece más a rellenar un formulario que a escribir una instrucción. El programa envía un estado, el texto o los datos sobre los que se pregunta, y una o varias preguntas de tres tipos. Una Choice elige una opción de una lista, hasta 255: ¿qué equipo debe atender este ticket, facturación, técnico o cuenta? Un Score sitúa el estado en una escala de niveles descritos: ¿cuán enfadado está el cliente, de 0 a 2? Y un Noul, el nombre que TypeSafe da a la pregunta de sí o no, devuelve la probabilidad de que la respuesta sea sí: ¿pide este mensaje una devolución? Cada pregunta se evalúa por separado y todas a la vez, y la documentación recomienda descomponer: en lugar de preguntar si hay que devolver el dinero, preguntar si el cliente lo pide, si el cargo está duplicado y si la política lo permite, y combinar las tres respuestas con lógica escrita en el programa.

De ahí sale su velocidad. Un modelo de lenguaje genera texto palabra a palabra, o más exactamente fragmento a fragmento, y cada fragmento exige recorrer la red entera otra vez, como hace a escala mínima el modelo de n-gramas que predice la palabra siguiente. Incluso cuando solo tiene que devolver {"equipo": "facturación"}, escribe la llave, las comillas, el nombre del campo y el valor, una pasada tras otra. Jev no genera nada: responde todas las preguntas en una sola consulta. TypeSafe mide tiempos de respuesta de entre 70 y 500 milisegundos, frente a los varios segundos habituales, cobra 0,042 dólares por millón de tokens de entrada, los fragmentos en que se trocea el texto, y no cobra la salida, que son unos pocos números. La empresa asegura que es de 40 a 200 veces más rápido y de 40 a 400 veces más barato que los modelos punteros en tareas comparables, con la precisión de estos. Esas cifras salen de flujos de trabajo que diseñó la propia empresa.

La otra mitad de la propuesta está en los números que acompañan a cada respuesta, y es lo que dibuja la figura de esta página. A la izquierda hay una pregunta Choice con tres opciones y sus probabilidades, que se pueden mover. De la forma de esa distribución sale la confianza: vale 1 si toda la probabilidad cae en una opción y 0 si se reparte por igual, y la figura la calcula con la aproximación que publica la propia documentación. Un programa puede actuar cuando la confianza supera un umbral y pasar el caso a una persona, o a un modelo más caro, cuando no. Ese mecanismo solo funciona si las probabilidades dicen la verdad, y a eso se llama estar calibrado: de todas las respuestas a las que el modelo da un 80 %, deben acertar más o menos ocho de cada diez.

Interactivo A la izquierda, mueve las probabilidades de las tres opciones y el umbral de confianza: por debajo, el programa no decide y escala el caso. A la derecha, dos mil respuestas simuladas de un modelo calibrado, uno sobreconfiado y uno tímido, agrupadas por la probabilidad que dieron; la diagonal es la calibración perfecta. La franja naranja son las respuestas que el umbral deja pasar.

El diagrama de la derecha muestra por qué eso importa. Un modelo calibrado sigue la diagonal, y con un umbral alto se automatizan menos casos pero se aciertan más, en la proporción que el modelo anunciaba. Un modelo sobreconfiado dice 95 % cuando acierta 80, y el umbral deja pasar errores que parecían seguros. Es un defecto documentado de los asistentes actuales: el informe técnico de GPT-4, de 2023, mostraba que el modelo antes de ajustarlo con valoraciones humanas estaba muy bien calibrado, y que después lo estaba bastante menos. TypeSafe sostiene que el problema está en el objetivo, porque entrenar para dar respuestas que gustan a las personas premia la seguridad en el tono, y entrena Jev con otro método al que llama RLCD, aprendizaje por refuerzo para decisiones calibradas, en el que las probabilidades se ajustan contra resultados. Según la empresa, el modelo es un transformador, como los de lenguaje, y se entrenó solo con datos sintéticos. Qué datos y con qué arquitectura exacta no lo ha publicado.

La documentación es franca sobre sus límites, que llama las aristas del modelo. Jev lee de forma literal, responde a la pregunta escrita y no a la que se quiso hacer. No cuenta bien, ni letras ni elementos de una lista. No compara fechas ni hace cuentas, y la recomendación es sacar todo eso al programa: que el modelo extraiga el mes y el día, y que el código decida cuál es anterior. Tampoco razona en varios pasos, porque no tiene dónde: pensar despacio exigiría generar, que es justo lo que ha dejado de hacer.

Las críticas se han centrado en dos promesas. La primera es que Jev no puede alucinar. Es cierto en un sentido estrecho, porque no puede inventar un campo que no existe ni devolver algo que no encaje en el formato; pero, como han señalado Anthony Maio y Sean Goedecke, nada le impide elegir la opción equivocada con una probabilidad alta, y eso, para quien recibe la respuesta, es un error como cualquier otro. La calibración (calibration), además, describe grupos de respuestas y no garantiza ninguna en particular, algo que la propia TypeSafe advierte. La segunda es la novedad: Goedecke recuerda que un modelo de lenguaje ya puede responder a una pregunta cerrada generando un único fragmento restringido a las opciones dadas, lo que se lleva buena parte de la ventaja de velocidad. Y Maio observa que en una de las comparativas publicadas las respuestas de referencia se obtuvieron promediando las de otros dos modelos, no de datos reales, lo que emparenta la evaluación con el problema del juez automático.

Lo que nadie discute es el hueco que ocupa. Vercel contó que el 13 % de los clientes de pago de su pasarela de modelos lo había probado en las primeras veinticuatro horas, el doble que con cualquier lanzamiento anterior, y los usos que se repiten son los que un programa hace miles de veces por minuto: clasificar tickets, filtrar mensajes, puntuar pasajes antes de pasárselos a otro modelo, decidir a quién le toca. El reparto que propone TypeSafe tiene sentido con o sin sus cifras: el modelo de lenguaje para lo abierto, que es escribir, razonar y explicar, y un modelo pequeño y rápido para las decisiones cerradas, con un programa en medio que sabe cuándo fiarse de cada uno. La paradoja de Jevons dice lo que pasará si funciona: nadie ahorrará en decisiones automáticas, se tomarán muchas más.

Capítulo 12 de 13

Efecto ELIZA

Informática 547 palabras artículo suelto ↗

El efecto ELIZA (en inglés, ELIZA effect) es la tendencia a atribuir comprensión, intención y vida interior a un programa informático a partir de indicios superficiales de su conducta verbal, incluso cuando se conoce con exactitud lo poco que el programa hace. Toma su nombre de ELIZA, el programa que Joseph Weizenbaum escribió en el Instituto Tecnológico de Massachusetts entre 1964 y 1966, y designa un fenómeno que no está en la máquina sino en el observador: la disposición humana a completar con una mente ajena cualquier secuencia de signos que lo permita.

ELIZA era, técnicamente, muy poco. Reconocía palabras clave en la frase del usuario, aplicaba unas reglas de transformación sintáctica y devolvía la frase reformulada, con un repertorio de fórmulas neutras para los casos en que no encontraba nada. El guion más conocido, DOCTOR, imitaba a un psicoterapeuta rogeriano por una razón puramente instrumental: es el único papel conversacional en el que responder a todo con una pregunta que devuelve el material del interlocutor resulta verosímil y no exige ningún conocimiento del mundo. Si el usuario escribía que su madre lo odiaba, el programa contestaba preguntando por su madre. No había representación del significado, ni memoria de la conversación más allá de unos turnos, ni modelo alguno del usuario.

La reacción del público fue lo que convirtió el experimento en un problema filosófico. Weizenbaum relató que su propia secretaria, que había visto el programa por dentro, le pidió tras unos minutos que saliera del despacho para poder seguir conversando en privado; que usuarios con formación técnica insistían en que la máquina los entendía; y que algunos psiquiatras llegaron a proponer el sistema como herramienta clínica en centros con escasez de terapeutas. Weizenbaum, que había escrito ELIZA precisamente como una parodia de la superficialidad de la comunicación entre hombre y máquina, quedó lo bastante alarmado para dedicar el resto de su carrera a la crítica de la informatización del juicio humano; el resultado fue Computer Power and Human Reason (1976), un libro escrito por un pionero de la inteligencia artificial (artificial intelligence) contra las pretensiones de la inteligencia artificial. La expresión efecto ELIZA se consolidó después en la literatura, con Douglas Hofstadter entre quienes la difundieron, para nombrar la ilusión que él describe como la susceptibilidad a leer mucha más comprensión de la que hay en una cadena de símbolos.

El concepto es más pertinente ahora que cuando se acuñó. Los sistemas conversacionales basados en grandes modelos de lenguaje (large language models) producen texto fluido, contextual y verosímil, con lo que la señal superficial de la que se alimenta el efecto es incomparablemente más rica que la de un guion de doscientas reglas, mientras la pregunta sobre lo que ocurre por debajo sigue abierta y en disputa. Sus consecuencias prácticas son medibles: usuarios que atribuyen conciencia al sistema, vínculos afectivos con acompañantes artificiales, confianza depositada en respuestas sin verificación, e incidentes públicos como el del ingeniero de Google que en 2022 sostuvo que el modelo con el que trabajaba era una persona. La lección de 1966 se mantiene intacta en su parte incómoda: el efecto ELIZA no se corrige explicando al usuario cómo funciona el sistema, porque los primeros en experimentarlo fueron quienes lo habían programado.

Algoritmo – Automatización de tareas – Paradoja de Moravec – Subjetividad – Era Digital

Capítulo 13 de 13

Paradoja de Moravec

Informática 552 palabras artículo suelto ↗

La paradoja de Moravec (en inglés, Moravec’s paradox) constata que las tareas que los humanos consideran difíciles resultan comparativamente fáciles de automatizar, mientras que las que cualquier niño ejecuta sin esfuerzo son extraordinariamente difíciles. La formuló el investigador en robótica Hans Moravec en Mind Children (1988): es relativamente sencillo conseguir que un ordenador rinda a nivel adulto en un test de inteligencia o jugando a las damas, y muy difícil o imposible dotarlo de las capacidades perceptivas y motoras de un niño de un año. Marvin Minsky y Rodney Brooks llegaron por su cuenta a la misma conclusión, y Steven Pinker la resumió en 1994 diciendo que la principal lección de treinta y cinco años de investigación en inteligencia artificial (artificial intelligence) es que los problemas difíciles son fáciles y los fáciles son difíciles.

La explicación que propuso Moravec es evolutiva y bastante elegante. Las capacidades sensoriomotoras —reconocer una cara, mantener el equilibrio, agarrar un objeto de forma desconocida, caminar por terreno irregular— llevan cientos de millones de años sometidas a selección natural, y ocupan la mayor parte del cerebro en circuitos densamente optimizados. Precisamente porque están tan bien resueltas, funcionan sin esfuerzo consciente y son invisibles a la introspección: no tenemos acceso al procedimiento, solo al resultado, y de ahí la impresión de que son triviales. El razonamiento abstracto, el álgebra o el ajedrez, en cambio, son adquisiciones culturales muy recientes, se ejecutan de manera lenta y deliberada, y su procedimiento es explícito y verbalizable, que es la razón por la que se pueden programar. Lo difícil de automatizar no es lo que nos cuesta, sino lo que sabemos hacer sin poder explicar cómo.

Las consecuencias prácticas se han verificado repetidamente. Un programa venció al campeón mundial de ajedrez en 1997, y tres décadas más tarde ningún robot dobla la ropa de una casa cualquiera a velocidad humana. La manipulación de objetos deformables, el desplazamiento en entornos no preparados y el reconocimiento robusto en condiciones inesperadas siguen siendo cuellos de botella; en las pruebas de robótica de DARPA de 2015 los robots más avanzados del mundo se caían al abrir una puerta. La paradoja explica también el patrón de la automatización del trabajo, que ha avanzado con rapidez sobre tareas cognitivas rutinarias y codificables —contabilidad, tramitación, cálculo, traducción de textos estándar— y muy despacio sobre ocupaciones manuales no rutinarias que exigen destreza física en entornos variables: fontanería, cuidado de personas, cocina, mantenimiento. El estatus social de una ocupación y su resistencia a la automatización no guardan relación.

La paradoja está a la vez confirmada e invertida por los sistemas actuales. Los grandes modelos de lenguaje (large language models) han conquistado el terreno que Moravec consideraba el más difícil de todos —el lenguaje natural con sentido común, que las técnicas simbólicas no lograron nunca— y lo han hecho sin resolver el problema motor, con lo que la brecha entre el software capaz de redactar un informe jurídico y el hardware incapaz de recoger la mesa se ha ensanchado en lugar de cerrarse. El sesgo de fondo que la paradoja denunciaba sigue vigente: al juzgar qué es difícil para una máquina seguimos usando como escala lo que nos resulta difícil a nosotros, que es exactamente la medida equivocada.

Efecto ELIZA – Automatización de tareas – Algoritmo – División técnica del trabajo – Mercado de trabajo dual

Este itinerario ordena artículos de la enciclopedia; cada uno vive también suelto, con sus fuentes y su historial. ¿Le falta un capítulo o le sobra uno? Dínoslo.

Todos los itinerarios →