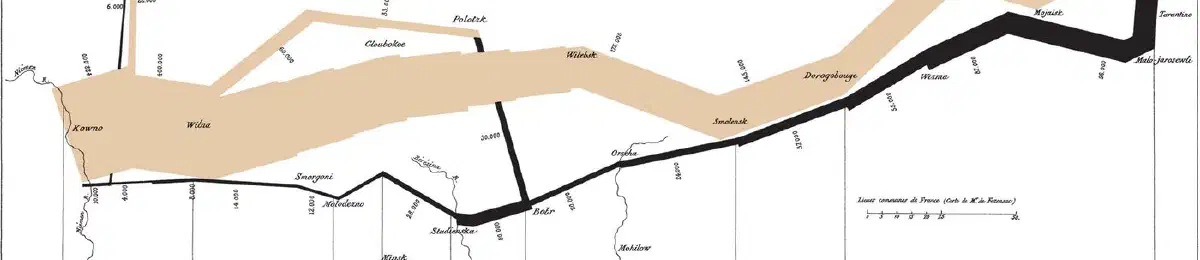
Carte figurative de las pérdidas del ejército francés en la campaña de Rusia — Leer los datos sin que te engañen
Charles Joseph Minard, 1869 · Public domain · Wikimedia Commons
Itinerarios / básico

Leer los datos sin que te engañen

Diez maneras en que un número correcto sostiene una conclusión falsa. Ninguna es un error de cálculo, y por eso no se ven revisando las cuentas.

10 capítulos · 9,600 palabras · 48 min · cada capítulo es un artículo de la enciclopedia

Diez casos en los que los datos son buenos, las cuentas están bien y la conclusión es falsa. No hace falta trampa ni mala fe: el fallo está antes, en quién entró en la muestra, o después, en cómo se agrupó o se usó lo que salió. Cada capítulo deja una pregunta para hacerse ante cualquier gráfico.

Los tres primeros van de lo que falta. La pregunta es qué decidió quién está en la tabla y quién no pudo llegar. Los negocios que cerraron, los aviones que no volvieron y los ensayos que no se publicaron no dejan hueco, y por eso la muestra parece completa. El sesgo de confirmación añade la pregunta más incómoda: qué haría falta para que yo estuviera equivocado.

Los tres siguientes van de las relaciones. Que dos cosas suban juntas no dice qué hacer a continuación, y la pregunta es qué tercera cosa podría mover las dos, como el calor, el paso del tiempo o el tamaño. El test del malvavisco es el ejemplo: con el nivel de la familia en la cuenta, el efecto casi desapareció. Y quien prueba veinte cosas encuentra alguna por azar, así que ante un hallazgo conviene preguntar cuántas se probaron.

Los dos siguientes van de agrupar. Un tratamiento puede ser mejor para los pacientes graves, mejor para los leves y peor en el total, así que antes de creerse la barra de arriba hay que mirar cómo se repartieron los grupos. Y lo extremo tiende a volver a lo normal sin que nadie haga nada: el peor hospital de este año probablemente mejorará el siguiente, con reforma o sin ella.

Los dos últimos van de lo que pasa cuando alguien mira. Un indicador que se convierte en objetivo deja de medir; si mejora sin pausa mientras empeora todo lo que no se mide, hay que preguntar qué se está comprando. Y la gente se comporta distinto cuando sabe que la observan.

No pide estadística previa, aunque va mejor después de Estadística descriptiva, de cero. Cada capítulo se lee suelto.

Capítulo 1 de 10

Sesgo de selección

Matemática y estadística 876 palabras artículo suelto ↗

El sesgo de selección es la distorsión que resulta de que los datos no hayan llegado al estudio al azar, sino mediante un proceso con tendencia a seleccionar unidades o individuos con ciertas características que dependen de la variable que se quiere explicar.

Dos millones de respuestas sesgadas pueden estar más lejos de la verdad que cincuenta mil bien elegidas, y la estadística aplicada conserva un episodio que lo demuestra con la contundencia de un naufragio: la encuesta más grande que se había hecho nunca falló por casi cuarenta puntos. Desde 1916 la revista neoyorquina The Literary Digest acertó el ganador de cinco elecciones presidenciales seguidas con un método espectacular: enviaba por correo millones de cuestionarios a sus suscriptores y a listas de propietarios de teléfonos y automóviles, y publicaba las respuestas recibidas. En 1936 desplegó la fórmula a su máximo: unos diez millones de cuestionarios enviados y 2,38 millones de respuestas, una cifra astronómica incluso hoy. Acertar cinco veces seguidas había convertido el tamaño de la muestra en argumento de autoridad: cuanta más gente respondía, pensaba la redacción, menos discusión cabía. La revista anunció que Alf Landon ganaría a Franklin D. Roosevelt con el 57% del voto popular y 370 votos electorales. El 3 de noviembre Roosevelt ganó con el 60,8% del voto, 523 votos electorales y todos los estados menos Maine y Vermont; el error en el margen superó los treinta y nueve puntos. La revista, arruinada de prestigio, dejó de publicarse en 1938.

El fallo no estaba en la aritmética sino en la puerta de entrada. Las tres listas —suscriptores de una revista, dueños de automóvil, usuarios de teléfono— excluían a la mayoría de los estadounidenses, y en plena Depresión ese filtro marcaba una renta muy por encima de la media; esa gente votaba más a los republicanos. Encima llegó el segundo filtro: responder era voluntario, y quienes detestaban a Roosevelt tenían más ganas de decirlo que los que estaban contentos con él. Investigaciones posteriores (Peverill Squire en 1988, Dominic Lusinchi en 2016) concluyeron que el sesgo de listas pesó, pero que el sesgo de no respuesta fue el principal responsable de la magnitud del error. Y que la revista hubiera acertado cinco veces seguidas no validaba el método: el sesgo estaba siempre; solo que hasta 1936 fue más pequeño que el margen de victoria.

Mientras tanto, George Gallup había fundado en 1935 el American Institute of Public Opinion con una idea opuesta: no importa cuánta gente responde, importa quién responde. Su última encuesta antes de la elección se hizo con unos cincuenta mil entrevistados elegidos para reproducir la composición del electorado, y dio a Roosevelt un 55,7% del voto: se quedó cinco puntos por debajo del 60,8% real, pero acertó signo y orden de magnitud con la cincuentava parte de las respuestas del Digest. El contraste fundó la encuesta científica moderna: la inferencia estadística exige que cada miembro de la población tenga una probabilidad conocida y distinta de cero de entrar en la muestra, y solo el muestreo aleatorio permite calcular esas probabilidades.

El sesgo de selección no vive solo en las urnas. En epidemiología laboral existe el healthy worker effect: las cohortes de trabajadores en activo parecen más sanas que la población general porque quienes enferman de verdad abandonan el empleo y desaparecen del estudio. El sesgo de Berkson (Joseph Berkson, 1946, desde la Clínica Mayo) advierte que estudiar solo a los pacientes hospitalizados fabrica asociaciones entre enfermedades que no existen fuera del hospital, porque la hospitalización depende de padecer más de una cosa a la vez. Las encuestas por teléfono descolgaron durante décadas a un país sin teléfono; las encuestas por internet descuelgan hoy a quien no quiere o no sabe responder por ese canal; y todo estudio que se nutre de voluntarios arrastra la rareza de quien se ofrece a participar.

Conviene, eso sí, ser honesto sobre lo que la aleatoriedad no logra. Un muestreo aleatorio de mil personas deja un error de muestreo de unos tres puntos para proporciones cercanas al 50% (

2p(1−p)/n≈3,2%2\sqrt{p(1-p)/n} \approx 3{,}2\%

con n=1000n=1000 y p=0,5p=0{,}5), pero no garantiza que quienes responden se parezcan a quienes no. En este sentido, las tasas de respuesta de las encuestas serias han caído del 80% de los años setenta a cifras de un solo dígito en algunos países. Pero la investigación sobre el tema da un resultado menos catastrófico de lo que sugiere la intuición: un estudio del Pew Research Center de 2012 comparó sus encuestas, con una tasa de respuesta del 9%, con otras mucho más caras con tasa del 22%, y encontró estimaciones políticas y sociales casi idénticas en ambas; el sesgo de no respuesta existe, pero su influencia es estrecha y específica, no el océano que imaginamos.

La pregunta operativa se formula antes de mirar dato alguno: ¿qué proceso decidió quién está en esta tabla y quién no pudo llegar? Si la respuesta depende de la variable que se quiere explicar —de la renta, de la salud, de la simpatía política—, esto es, si existe sesgo de selección, ningún tamaño de muestra, ninguna fórmula y ninguna potencia de cálculo reparará el diseño.

Sesgo del superviviente – Muestra representativa – Diseño muestral – La paradoja de Simpson

Capítulo 2 de 10

Sesgo del superviviente

Matemática y estadística 1087 palabras artículo suelto ↗

El sesgo del superviviente es el error de inferencia que se comete al estudiar únicamente los casos que han superado un proceso de selección, ignorando los que desaparecieron por el camino. Es una forma particular de sesgo de selección, y la más difícil de detectar, porque los datos ausentes no dejan hueco visible: la muestra parece completa. Lo que se mide con toda precisión es una población que ya ha sido filtrada por la misma variable que se pretende explicar.

El ejemplo fundacional viene de la Segunda Guerra Mundial. El Statistical Research Group, un equipo de matemáticos reunido por la Universidad de Columbia para asesorar al ejército estadounidense, recibió la pregunta de dónde reforzar el blindaje de los bombarderos, y los datos disponibles eran los impactos contabilizados en los aviones que volvían: muchos en fuselaje y alas, pocos en motores y cabina. La conclusión intuitiva era blindar donde había más agujeros. Abraham Wald, matemático judío húngaro emigrado a Estados Unidos en 1938, razonó al contrario: los aviones examinados eran precisamente los que habían sobrevivido, de modo que la escasez de impactos en los motores no indicaba que allí no impactaran las balas, sino que los aviones alcanzados en los motores no volvían para ser contados. El blindaje debía ir donde no había agujeros. En el equipo, dirigido por W. Allen Wallis, trabajaban también Milton Friedman y Jacob Wolfowitz, y el problema de Wald fue uno de los tantos en los que la estadística de guerra dejó matemática pura de regalo. Su memoria de 1943 sobre la estimación de la vulnerabilidad a partir de los datos de las supervivientes, desclasificada y publicada en 1980, sigue siendo el modelo de cómo se corrige un sesgo de este tipo: modelando explícitamente el proceso que hizo desaparecer las observaciones. Wald, que en el mismo periodo fundó la teoría de la decisión estadística y el análisis secuencial, murió en 1950, a los cuarenta y ocho años, en un accidente de aviación en la India, donde daba un ciclo de conferencias; la carrera que empezó contando agujeros en aviones supervivientes terminó sin supervivencia que contar.

Formación de bombarderos B-17 atravesando una cortina de fuego antiaéreo sobre Alemania
Fig. 1 B-17 Flying Fortress atravesando la cortina de flak, Alemania, 1944 (Fuerzas Aéreas del Ejército de Estados Unidos). Cada avión de la fotografía es un superviviente: los datos de impactos que inspiraron el razonamiento de Wald salían de aviones exactamente como estos, que volvieron. Las decisiones de blindaje se tomaron con la información ausente modelada, no ignorada.U.S. Army Air Force · 1944 · Dominio público · Wikimedia Commons

El sesgo estructura silenciosamente sectores enteros. Las series históricas de rentabilidad de fondos de inversión miden solo los fondos que siguen existiendo: los que quebraron o fueron liquidados salen de la base de datos, y los informes SPIVA de S&P documentan periódicamente que una fracción considerable de los fondos que existían quince años antes ya no están, lo que infla la rentabilidad media que publicita el sector. Las bases de datos de fondos de cobertura añaden un segundo filtro al primero: en buena parte se alimentan de fondos que reportan voluntariamente, y los que dejan de reportar suelen ser precisamente los que han perdido dinero, de modo que la ausencia y la vergüenza coinciden. La literatura de autoayuda empresarial entrevista a los fundadores que triunfaron y concluye que la clave fue abandonar los estudios o desoír el consejo ajeno, sin contar cuántos fracasados hicieron exactamente lo mismo; el dato correctivo existe y se puede medir: con registros censales de Estados Unidos, Benjamin Jones y sus coautores estimaron en 2020 que la edad media de los fundadores de las empresas de crecimiento más rápido ronda los cuarenta y cinco años, no los veinte. Se admira la solidez de la arquitectura romana o el sonido de los violines de Cremona sin contar los edificios y los instrumentos mediocres que el tiempo se llevó. Y en medicina veterinaria, un estudio publicado en 1987 sobre gatos caídos desde edificios altos de Nueva York halló que los que caían de más de siete plantas sufrían lesiones menos graves que los de plantas intermedias; una explicación plausible es la física de la caída, que deja de acelerar tras unas cinco plantas, y otra, que los gatos que morían en la caída no llegaban nunca a la clínica de la que salían los datos.

También la ciencia padece su propio sesgo de superviviente: el de los estudios publicados. Los ensayos con resultados positivos y significativos tienen más probabilidades de ver la luz que los que no encuentran nada, y durante décadas nadie registraba los que se hacían, así que el cajón de los fallidos era invisible. La respuesta fue institucional, no estadística: desde 2005 el International Committee of Medical Journal Editors exige el registro previo de todo ensayo clínico como condición para publicarlo, precisamente para que los ausentes consten desde el principio.

La defensa no es estadística sino de diseño. Consiste en preguntar, antes de mirar la tabla, qué proceso decidió quién entra en ella y qué haría un caso desaparecido para no aparecer: registros de todos los ensayos antes de conocer los resultados, bases de datos que conserven las entidades extinguidas, cohortes seguidas desde el inicio y no reconstruidas desde el final. Cuando la desaparición no se puede evitar, se modela: análisis de supervivencia —que toma su nombre de los estudios de mortalidad, no del sesgo—, corrección de Heckman de 1979 para la autoselección, límites de sensibilidad sobre lo que daría cualquier supuesto razonable sobre los ausentes. Lo que no funciona es la vía intuitiva, porque la intuición trabaja con lo que ve, y el sesgo del superviviente consiste exactamente en lo que no se ve.

Hay dos objeciones honestas que merecen respuesta. La primera: a veces estudiar a los supervivientes es legítimo, porque la pregunta es sobre los supervivientes —qué tratamiento funciona en quienes ya han resistido la primera fase de una enfermedad no exige saber nada de quienes no la resistieron. El error no es estudiar a quien queda, sino generalizar lo aprendido al proceso completo. La segunda: toda corrección supone algo sobre los casos inobservables, y ese algo no es comprobable con los datos disponibles. Wald tuvo que asumir que los impactos se distribuían por la superficie del avión sin depender de la zona, un supuesto plausible pero no verificable entre los restos de los que no volvieron; la corrección del sesgo convierte incertidumbre invisible en supuestos explícitos, lo cual es un progreso, no una solución.

Aun así, la pregunta sigue siendo la herramienta más barata y más descuidada de la estadística aplicada: ¿quién no está en la mesa? Funciona en la sala de máquinas de una aeronave de 1943, en el folleto de un fondo de inversión, en el catálogo de publicaciones de un laboratorio farmacéutico y en la biografía de cualquier consejo de éxito. Todos sus datos son correctos; por eso mismo conviene sospechar.

Sesgo de selección – Muestra sesgada – Diseño muestral – La regresión a la media – La paradoja de Simpson

Capítulo 3 de 10

Sesgo de confirmación

Metodología 885 palabras artículo suelto ↗

El sesgo de confirmación es la tendencia a buscar, recordar e interpretar la información de manera que respalde lo que ya se cree. No es un defecto de las personas poco informadas ni un vicio que se corrija con esfuerzo: es una regularidad de la cognición humana documentada en experimentos desde los años sesenta, que opera sin conciencia de estar operando y que afecta con la misma fuerza a expertos y a legos, con la particularidad de que en los expertos suele producir errores más difíciles de detectar porque vienen mejor argumentados.

La primera descripción clara es muy anterior a la psicología experimental. Francis Bacon la formuló en el Novum Organum (1620) como uno de los ídolos de la mente: el entendimiento humano, escribió, una vez ha adoptado una opinión, atrae todo lo demás para apoyarla, y aunque encuentre más fuerza y número en los casos contrarios, los desprecia o los aparta mediante distinciones. La formulación experimental llegó con Peter Wason, que en 1960 planteó a sus sujetos una tarea de descubrimiento de reglas y observó que casi todos proponían ejemplos que encajaban con su hipótesis en lugar de intentar refutarla; en 1966 diseñó la tarea de selección que lleva su nombre, en la que la inmensa mayoría de los participantes elige comprobar los casos que confirmarían la regla en vez de los que podrían falsarla, aunque la lógica exija lo contrario.

Portada del Novum Organum de Francis Bacon, con un barco atravesando las columnas de Hércules
Fig. 1 Portada del Novum Organum (1620), con el navío que atraviesa las columnas de Hércules y el lema «muchos pasarán y el conocimiento crecerá». En ese libro Bacon describió el sesgo de confirmación con una precisión que los experimentos no han mejorado en cuatro siglos, y propuso como remedio el método: no confiar en la mente sino en un procedimiento que la corrija.Portada del «Novum Organum» de Francis Bacon · 1620 · Dominio público · Wikimedia Commons

El sesgo actúa en cuatro momentos distintos, y distinguirlos ayuda a entender por qué es tan difícil de neutralizar. En la búsqueda, lleva a formular preguntas cuya respuesta afirmativa confirma la hipótesis y a consultar fuentes previsiblemente favorables. En la interpretación, hace que la evidencia ambigua se lea como apoyo, y —efecto más inquietante— que la misma evidencia mixta refuerce las posiciones contrarias de dos personas que la examinan, fenómeno llamado polarización de actitudes que se documentó por primera vez con datos sobre la pena de muerte. En la memoria, favorece el recuerdo selectivo de los casos que encajan. Y en la evaluación de la fuente, produce un doble estándar: los estudios que contradicen lo que se cree reciben un escrutinio metodológico mucho más severo que los que lo confirman, y el escrutinio severo es en sí mismo legítimo, lo que hace que el sesgo se disfrace de rigor.

En investigación, sus efectos son bien conocidos y tienen nombre propio. El sesgo de publicación hace que los resultados negativos se publiquen menos, con lo que la literatura acumulada sobrestima los efectos. El HARKing consiste en formular la hipótesis después de ver los datos y presentarla como previa. El p-hacking consiste en probar variantes de análisis hasta que alguna alcance la significación. Ninguna de esas prácticas requiere mala fe: bastan un investigador convencido de su hipótesis y un conjunto de decisiones analíticas razonables tomadas una tras otra. La respuesta institucional ha ido en la dirección correcta —registro previo de hipótesis y análisis, informes de resultados aceptados antes de conocerlos, publicación obligatoria de datos, replicación sistemática— y su lógica es la de Bacon: no pedir a los investigadores que sean imparciales, sino diseñar un procedimiento en el que la parcialidad no pueda actuar.

Fuera del laboratorio, el sesgo explica bastante de lo que se atribuye a la mala fe. En medicina, la impresión diagnóstica inicial condiciona qué pruebas se piden y cómo se leen, y de ahí los protocolos de diagnóstico diferencial, que obligan a formular explícitamente las alternativas. En investigación policial y forense, el conocimiento del sospechoso contamina la interpretación de indicios ambiguos, y por eso se recomiendan procedimientos ciegos en las ruedas de reconocimiento y en el análisis de muestras. En la evaluación de personal, la primera impresión determina qué se pregunta en el resto de la entrevista. Y en el consumo de información, el efecto se combina con la selección algorítmica: los sistemas de recomendación optimizan la permanencia, y el contenido que confirma lo que uno ya piensa retiene mejor, de modo que el sesgo individual y el incentivo comercial apuntan en la misma dirección. Conviene precisar, eso sí, que la evidencia empírica sobre las burbujas de filtro es más matizada de lo que sugiere el término: varios estudios encuentran que los consumidores de noticias en línea están expuestos a más diversidad de fuentes que los de medios tradicionales, y que el problema principal no es la falta de exposición a la opinión contraria sino la interpretación hostil de esa exposición.

Sobre los remedios, la investigación es menos optimista de lo que a nadie le gustaría. Informar a alguien de la existencia del sesgo no lo reduce, y advertir de él puede aumentar la confianza en el propio juicio. Lo que sí funciona, con efectos modestos pero medibles, son procedimientos externos: obligarse a enumerar por escrito las razones por las que la propia conclusión podría ser errónea —la técnica de «considerar lo contrario»—, asignar formalmente a alguien el papel de argumentar en contra, someter la decisión a un grupo con intereses divergentes, y sobre todo fijar de antemano qué observación se aceptaría como refutación. Esa última es la más potente y la más incómoda, porque exige responder antes de mirar a la pregunta que el sesgo de confirmación está diseñado para evitar: qué haría falta para que yo estuviera equivocado.

Falacias – Navaja de Occam – Hipótesis nula – Sesgo de selección – Efecto Hawthorne

Capítulo 4 de 10

Correlación espuria (correlación espúrea)

Matemática y estadística 627 palabras artículo suelto ↗

La correlación espuria o correlación espúrea es una correlación estadística intensa y a menudo significativa entre dos variables que no están unidas por ninguna relación causal. La cifra es real: los datos existen, el coeficiente se calcula correctamente y la prueba de significación se pasa. Lo que no existe es el vínculo que la mente del lector añade al ver el número. Por ejemplo, se puede encontrar una correlación intensa entre ventas de lavadoras y número de nacimientos, pero no existe base teórica para establecer un vínculo entre ambas variables; es por tanto una correlación espuria.

Hay tres mecanismos distintos que generan correlación espuria y conviene distinguirlos, porque el remedio de cada uno es diferente. El primero es la variable de confusión: una tercera causa mueve a las dos observadas y las hace subir y bajar juntas. El caso de manual es la correlación entre el consumo de helados y los ahogamientos, que en los datos veraniegos de cualquier país rico es intensa —las dos series alcanzan su máximo en julio y agosto y su mínimo en pleno invierno—, y cuya causa común es el calor: los helados no ahogan a nadie, y los ahogamientos no dan ganas de helado. El segundo es la tendencia compartida: dos series que crecen con los años correlacionan casi siempre porque ambas correlacionan con el tiempo; es el mecanismo de las regresiones de Granger y Newbold. El tercero es la selección de la muestra: si el criterio por el que un caso entra en los datos depende de las dos variables a la vez, aparece entre ellas una correlación que no está en la población, como la nota negativa entre examen y entrevista entre los ya admitidos en una universidad selectiva. A este grupo pertenece también la correlación ecológica: un coeficiente calculado sobre grupos —países, provincias, barrios— puede ser alto y verdadero a ese nivel y no transferirse a las personas que viven dentro, advertencia que W. S. Robinson formalizó en 1950 con el nombre de falacia ecológica. Los países con muchas bibliotecas tienen más premios Nobel; nadie por eso gana un Nobel leyendo.

La fórmula «correlación no implica causalidad» es correcta pero insuficiente, porque no dice qué hay que hacer a continuación. La respuesta la ha dado la literatura de inferencia causal desarrollada por Judea Pearl y otros: para decidir si una asociación admite lectura causal hay que declarar previamente un modelo de qué causa a qué, y ese modelo determina qué variables hay que controlar y —lo que se olvida más— qué variables no se deben controlar. Ajustar por una variable que es consecuencia de las dos, y no causa, introduce sesgo en lugar de eliminarlo, y la estrategia de «controlar por todo lo disponible» no es prudente: es una manera fiable de fabricar correlaciones espurias nuevas, en ocasiones de signo invertido, como muestra la paradoja de Simpson.

A veces una correlación empieza siendo espuria y termina siendo causal. Por ejemplo, la relación entre tabaco y cáncer de pulmón empezó siendo puramente correlacional —el estudio de caso y control de Doll y Hill en 1950, la cohorte de médicos británicos en 1954— y finalmente se ha convertido en la conclusión causal mejor establecida de la epidemiología moderna.

La correlación espúrea no condena la correlación: la pone en su sitio, que es el de señal de entrada y no el de prueba. Casi todo lo que la ciencia sabe empezó con alguien que notó que dos cosas subían juntas; el error no es mirar la asociación, sino dejar de hacerse preguntas en cuanto aparece el número. El coeficiente es un detector excelente y un argumento pésimo, y sigue siendo útil exactamente mientras se le trata así.

Correlación – Sesgo de selección – La paradoja de Simpson – La regresión a la media – Ley de Goodhart

Capítulo 5 de 10

El test del malvavisco

Psicología 797 palabras artículo suelto ↗

El test del malvavisco, también llamado experimento de la golosina, es una prueba de autocontrol para niños pequeños que el psicólogo Walter Mischel empezó a hacer a finales de los años sesenta en una guardería de la Universidad de Stanford. Un adulto sentaba a un niño de entre tres y cinco años delante de una golosina y le hacía una oferta: podía comérsela ya, o esperar a que el adulto volviera y entonces tendría dos. Años después, Mischel descubrió que los niños que habían esperado más tiempo sacaban mejores notas en la adolescencia, y el test se convirtió en uno de los experimentos más famosos de la psicología y en un símbolo de la importancia de la fuerza de voluntad. Las investigaciones posteriores han rebajado mucho esa conclusión.

La prueba era sencilla. En una sala sin distracciones, el niño elegía su golosina preferida entre varias (un malvavisco, una galleta, un palito salado) y se le explicaba que el adulto tenía que salir un momento. Si esperaba sin comérsela hasta que volviera, recibiría dos. Si no podía más, bastaba con tocar una campanilla: el adulto volvería enseguida, pero solo tendría una. Después se medía cuánto tiempo aguantaba, con un límite de unos quince o veinte minutos.

Varios malvaviscos blancos pinchados en palitos de madera sobre un hornillo de camping
Fig. 1 Malvaviscos, la golosina que dio nombre a la prueba, aunque los niños podían elegir también una galleta o un palito salado.Eden Aviv · CC0 (dominio público) · Wikimedia Commons

Los primeros estudios de Mischel no buscaban predecir el futuro, sino entender cómo consiguen esperar los niños. Y ahí están algunos de sus hallazgos más sólidos. Esperar era mucho más difícil con la golosina a la vista que tapada. Los niños que se distraían (cantando, mirando al techo, dándose la vuelta, jugando con los pies) aguantaban más que los que la miraban fijamente. Y pensar en la golosina de forma abstracta, imaginando que el malvavisco era una nube o una foto, ayudaba más que pensar en lo rica que estaba. El autocontrol, en otras palabras, no era solo una cuestión de fuerza, sino de estrategias que se pueden aprender.

La fama llegó con los seguimientos. Mischel volvió a contactar a los niños de la guardería, ya adolescentes, y en 1988 y 1990 publicó que quienes habían esperado más de pequeños eran descritos por sus padres como más competentes y mejores gestionando la frustración, y tenían mejores resultados en el examen de acceso a la universidad. Estudios posteriores relacionaron la espera con un menor índice de masa corporal y otros indicadores de éxito adulto. La idea de que un test de quince minutos a los cuatro años predecía la vida entera recorrió libros de autoayuda, charlas de empresa y programas educativos.

El problema es que aquellos niños no eran una muestra cualquiera. Eran hijos de profesores y estudiantes de Stanford, un grupo pequeño y muy privilegiado, y los datos de los seguimientos procedían de una parte reducida de ellos, en algunos análisis apenas unas decenas. En 2018, Tyler Watts, Greg Duncan y Haonan Quan repitieron la idea con unos 900 niños de un gran estudio nacional estadounidense, mucho más diverso. La relación entre esperar a los cuatro años y los resultados escolares a los quince existía, pero era aproximadamente la mitad de fuerte. Y cuando tuvieron en cuenta el nivel económico y educativo de la familia y las capacidades cognitivas tempranas del niño, se reducía en unos dos tercios y dejaba de ser significativa en la mayoría de los casos. Buena parte de lo que parecía autocontrol era, en realidad, el reflejo del entorno en el que crecía el niño.

Un experimento de 2013 ayudó a entender por qué. Celeste Kidd y su equipo, en la Universidad de Rochester, prometieron a un grupo de niños unos materiales de dibujo mejores si esperaban, y en la mitad de los casos cumplieron la promesa y en la otra mitad no. Después hicieron el test del malvavisco. Los niños que habían comprobado que el adulto era de fiar esperaron de media unos doce minutos; los que habían comprobado que no lo era, unos tres. Para un niño que vive en un entorno donde las promesas no se cumplen, comerse la golosina cuanto antes no es falta de voluntad, sino una decisión razonable.

El test del malvavisco sigue siendo útil, pero para otra cosa que la que lo hizo famoso. Mide una capacidad real, la de retrasar una recompensa, que depende de la edad, de las estrategias que el niño conoce y de si confía en quien le hace la promesa. No es un oráculo del éxito futuro, y usarlo para etiquetar a un niño de cuatro años es exactamente lo contrario de lo que enseñan los datos. El caso muestra, además, un error clásico al leer datos: una correlación entre dos cosas puede deberse casi por completo a una tercera, en este caso la familia, que influye en ambas.

Correlación espuria (correlación espúrea) – Tamaño muestral (tamaño de la muestra) – Sesgo de selección – El agotamiento del ego – Replicabilidad (reproducibilidad) – La regresión a la media

Capítulo 6 de 10

Las comparaciones múltiples

Matemática y estadística 1276 palabras artículo suelto ↗

El problema de las comparaciones múltiples (en inglés, multiple comparisons) es que la probabilidad de encontrar por azar un resultado estadísticamente significativo crece con el número de cosas que se prueban. El umbral de significación habitual, un valor p por debajo de 0,05, garantiza que una hipótesis falsa solo pasará por verdadera una vez de cada veinte. Pero si se prueban veinte hipótesis falsas a la vez, lo esperable es que una pase, y la probabilidad de que pase al menos una es del 64 por ciento. Con cien, del 99. Quien busca en suficientes sitios encuentra siempre algo, y si solo cuenta dónde lo encontró, el resultado tiene el mismo aspecto que un descubrimiento.

Randall Munroe dibujó el problema en 2011 en una tira de su serie xkcd. Unos científicos investigan si las gominolas causan acné, y no encuentran relación. Les piden que prueben color por color, y prueban veinte. Diecinueve salen sin efecto; las verdes, con p menor que 0,05. Al día siguiente, el titular del periódico dice que las gominolas verdes causan acné, con un 95 por ciento de confianza y una probabilidad de uno entre veinte de que sea casualidad. La figura reproduce el experimento y lo generaliza. Cada punto es el valor p de una hipótesis, ordenados de menor a mayor en escala logarítmica, y la zona sombreada es la que se declara significativa según el criterio elegido.

Interactivo Elige cuántas hipótesis se prueban y cuántas tienen un efecto real, y haz estudios. Sin corrección, con veinte hipótesis y ningún efecto, casi dos de cada tres estudios encuentran algo. Bonferroni baja el umbral a 0,05 dividido por el número de pruebas y elimina casi todas las falsas alarmas, a costa de perder efectos reales; Benjamini-Hochberg sube el umbral con el puesto de cada valor p y controla qué fracción de los hallazgos es falsa.

Con los valores de partida, veinte hipótesis sin ningún efecto real, cada estudio es el de las gominolas. Unas veces no sale nada; muchas sale un color, y a veces dos. Al pulsar para hacer mil estudios, la proporción de los que encuentran al menos una falsa alarma se queda cerca del 64 por ciento que da la cuenta, uno menos 0,95 elevado a veinte. Ninguno de esos estudios ha hecho nada mal en cada prueba por separado. El error está en la suma: la probabilidad de equivocarse que se había fijado en el 5 por ciento era la de cada prueba, y lo que se ha hecho es darse veinte oportunidades.

El ejemplo más célebre de lo que pasa cuando no se corrige es un salmón. En 2009, Craig Bennett y otros tres neurocientíficos metieron en un escáner de resonancia magnética funcional un salmón del Atlántico comprado en un supermercado, muerto, y le enseñaron fotografías de personas en situaciones sociales mientras le pedían que dijera qué emociones sentían. Analizaron las imágenes con el procedimiento estándar, que prueba por separado si cada uno de los miles de vóxeles del cerebro, los píxeles tridimensionales de la imagen, se activa con la tarea, y sin corregir por el número de pruebas. Encontraron un grupo de vóxeles activos en el cerebro del pez. Con la corrección, desaparecieron. Lo presentaron primero como póster y lo publicaron en 2010 en una revista de resultados inesperados, con un subtítulo que era la tesis: un argumento a favor de la corrección adecuada para comparaciones múltiples. En aquel momento, una parte considerable de los artículos de neuroimagen no la aplicaba, y el estudio, que recibió el premio Ig Nobel de neurociencia en 2012, contribuyó a que hoy casi todos lo hagan.

La corrección más sencilla es la de Bonferroni, que debe su nombre al matemático italiano Carlo Emilio Bonferroni, autor en 1936 de la desigualdad en la que se basa, y que Olive Jean Dunn convirtió en 1961 en un procedimiento práctico. Consiste en dividir el umbral por el número de pruebas: con veinte hipótesis, cada una tiene que bajar de 0,05/20 = 0,0025 para contar. Así la probabilidad de que salga al menos una falsa alarma en todo el estudio, lo que se llama tasa de error por familia (family-wise error rate), no pasa del 5 por ciento. La genética usa una versión extrema: en los estudios que prueban un millón de variantes del genoma a la vez, el umbral de significación es de 5 × 10⁻⁸, que es aproximadamente 0,05 dividido entre un millón. La física de partículas exige cinco sigmas, un p del orden de uno entre tres millones, en parte por la misma razón: cuando se buscan picos a lo largo de todo un rango de energías, alguno saldrá por azar, y a eso los físicos lo llaman efecto de mirar en otra parte (look-elsewhere effect).

El precio de Bonferroni es la potencia. Con un umbral veinte veces más exigente, los efectos reales también cuesta más detectarlos, y si se prueban mil hipótesis el umbral es tan estricto que casi nada lo supera. Yoav Benjamini y Yosef Hochberg propusieron en 1995 cambiar la pregunta. En lugar de controlar la probabilidad de cometer una sola falsa alarma, controlar la proporción de falsas alarmas entre los hallazgos, que llamaron tasa de falsos descubrimientos (false discovery rate). El procedimiento ordena los valores p de menor a mayor y compara el que ocupa el puesto i con 0,05 × i/m, donde m es el número de pruebas: el umbral sube escalón a escalón, y se aceptan todos los valores hasta el último que queda por debajo de su escalón. En la figura se ve como una rampa. Si se ponen varias hipótesis con efecto real, Benjamini-Hochberg detecta más que Bonferroni y mantiene las falsas alarmas en torno a un 5 por ciento de lo que declara, no de lo que prueba. El artículo de 1995 es uno de los más citados de toda la estadística, porque llegó justo cuando la genómica empezaba a probar miles de genes a la vez.

Las correcciones resuelven el problema cuando se sabe cuántas pruebas se han hecho. El caso difícil es cuando no se sabe, porque las comparaciones no se hacen de una vez sino a lo largo de un análisis. Un investigador recoge datos y puede decidir qué variable medir entre varias parecidas, si excluir a los participantes que respondieron demasiado deprisa, si analizar a hombres y mujeres juntos o por separado, si controlar por la edad, cuándo dejar de recoger datos. Cada decisión es razonable por sí sola, y ninguna se toma con intención de engañar, pero todas se toman después de ver los datos, y cada camino posible es una comparación más. Andrew Gelman y Eric Loken lo llamaron en 2013 el jardín de los senderos que se bifurcan, tomando el título del cuento de Borges, y señalaron que el problema existe aunque el investigador solo haya recorrido un sendero: basta con que, si los datos hubieran salido de otra manera, hubiera elegido otro. Es lo que Joseph Simmons, Leif Nelson y Uri Simonsohn demostraron en 2011 con datos inventados, y lo que se ha llamado p-hacking cuando se hace a sabiendas.

Contra esa versión del problema no hay fórmula, y la solución que se ha ido imponiendo es de procedimiento: registrar el análisis antes de recoger los datos, de modo que el número de comparaciones quede fijado de antemano y cualquier otra se presente como lo que es, exploratoria. También cambia la manera de leer. Un hallazgo que sale de un estudio que probó muchas cosas, sobre todo si es sorprendente y el estudio no dice cuántas probó, merece la misma desconfianza que el titular de las gominolas verdes. Y el problema no es exclusivo de la ciencia: el inversor que prueba cien estrategias con los datos del pasado y se queda con la que habría ganado, el aficionado que encuentra en los datos de la lotería el número que «sale más», o el que se asombra de una coincidencia sin pensar en todas las que no ocurrieron, están haciendo, como en el problema del cumpleaños, comparaciones múltiples sin contarlas.

Capítulo 7 de 10

La paradoja de Simpson

Matemática y estadística 988 palabras artículo suelto ↗

La paradoja de Simpson es el fenómeno por el que una tendencia que aparece en cada uno de varios grupos desaparece, o se invierte, cuando los grupos se juntan. Un tratamiento puede ser mejor que otro para los pacientes graves y también para los leves, y peor en el total; una universidad puede admitir a las mujeres en mayor proporción que a los hombres en cada departamento y en menor proporción en el conjunto. No hay error de cálculo en ninguna de las dos cifras. Las dos son ciertas, y la paradoja está en que la pregunta «¿cuál es mejor?» no tiene una sola respuesta hasta que se decide qué se está comparando con qué.

El caso más citado es el de las admisiones de posgrado en la Universidad de California en Berkeley en el otoño de 1973. La universidad había recibido 12.763 solicitudes y admitido al 44 % de los hombres y al 35 % de las mujeres, una diferencia que parecía una prueba de discriminación y que motivó un estudio interno. Peter Bickel, Eugene Hammel y William O’Connell revisaron las cifras departamento por departamento y encontraron lo contrario: en la mayoría de ellos las mujeres eran admitidas en igual o mayor proporción. La figura de esta página recoge los seis departamentos más grandes que el artículo publicó con sus datos completos, los mismos que se han reproducido en manuales durante medio siglo.

Interactivo Cada barra es el porcentaje de éxito de un grupo, y su grosor, cuántas personas hay detrás. Arriba, todos juntos; debajo, estrato a estrato. El deslizador reparte las solicitudes del segundo grupo como las del primero, sin tocar la tasa de éxito de nadie: mira lo que le pasa a la barra de arriba. El otro caso es un ensayo médico real con dos operaciones de cálculos renales.

La explicación está en la figura, en el grosor de las barras. Los hombres solicitaban sobre todo los departamentos A y B, donde entraba más de la mitad de los candidatos; las mujeres, los departamentos C, D, E y F, donde entraba menos de un tercio. Cada grupo compite en un terreno distinto, y la media global de las mujeres se hunde no porque les vaya peor en algún sitio, sino porque compiten donde todo el mundo pierde. Bickel y sus colegas lo formularon con cuidado: los datos no probaban que hubiera discriminación en las admisiones, aunque sí planteaban por qué los departamentos con más plazas eran los que recibían menos solicitudes de mujeres, una pregunta que la tabla no puede responder. El deslizador de la figura hace el experimento mental que ellos hicieron con lápiz: si las mujeres se hubieran repartido entre departamentos como los hombres, con las mismas tasas de admisión departamento a departamento, habrían entrado en mayor proporción que ellos.

El segundo caso de la figura muestra que la paradoja no es una curiosidad de las estadísticas sociales. En 1986 Clive Charig y sus colegas del Instituto de Urología de Londres compararon dos técnicas para eliminar cálculos renales: la cirugía abierta y la nefrolitotomía percutánea, una intervención menos invasiva. En conjunto, la percutánea tenía más éxito, 83 % frente a 78 %. Pero al separar las piedras pequeñas de las grandes, la cirugía abierta ganaba en ambos grupos. El motivo es el mismo que en Berkeley con otros nombres: los cirujanos reservaban la operación abierta para los casos difíciles, las piedras grandes, y eso arrastraba su media hacia abajo. Steven Julious y Mark Mullee usaron precisamente estos datos en 1994 para advertir a los lectores del British Medical Journal de que una tabla agregada puede señalar el tratamiento equivocado.

El nombre honra a Edward Simpson, un estadístico británico que en 1951 describió el fenómeno en un artículo sobre la interpretación de tablas de contingencia, aunque no lo llamó paradoja ni pretendió haberlo descubierto. Karl Pearson en 1899 y George Udny Yule en 1903 ya habían notado que una asociación presente en dos subpoblaciones podía desaparecer al mezclarlas. El nombre lo puso Colin Blyth en 1972, en un artículo que relacionaba el fenómeno con el «principio de lo seguro» de la teoría de la decisión: si una acción es preferible tanto si ocurre un suceso como si no ocurre, debería ser preferible sin más. La paradoja parece violarlo, y buena parte de la literatura posterior ha consistido en explicar por qué en realidad no lo hace.

La resolución que hoy se acepta la dio Judea Pearl, y consiste en decir que la paradoja no es un problema de aritmética sino de causalidad. Las cifras agregadas y las estratificadas son igual de correctas; la pregunta es cuál responde a lo que queremos saber, y eso depende de cómo se relacionan las variables. En el caso de los cálculos renales, el tamaño de la piedra influye a la vez en qué tratamiento se elige y en el resultado: es una variable de confusión, y la respuesta correcta es la estratificada, porque compara pacientes comparables. Pero Pearl construye ejemplos con las mismas tablas en los que la variable por la que se estratifica es una consecuencia del tratamiento —la tensión arterial que un fármaco modifica, por ejemplo—, y entonces separar por ella es un error y la cifra correcta es la agregada. Los números no pueden decidir; hace falta un modelo de qué causa qué.

De ahí la lección que el fenómeno enseña y que el nombre de paradoja tiende a ocultar. No hay nada misterioso en que una media global dependa de cómo se pesan sus partes: ocurre cada vez que dos grupos se reparten de forma distinta entre situaciones de distinta dificultad. Lo que parece paradójico es la pretensión de que una sola cifra resuma una comparación. Cuando un informe dice que un colegio, un hospital o un país obtiene mejores resultados que otro, la pregunta que la paradoja obliga a hacer es con qué población trabaja cada uno, y si la diferencia entre poblaciones explica la diferencia entre resultados. La figura de esta página deja repartir a los solicitantes de Berkeley con un dedo; en la práctica, ese reparto es lo que hay que ir a buscar antes de creerse la barra de arriba.

Correlación espuria (correlación espúrea) – Sesgo de selección – Datos agregados – Estadística descriptiva y estadística inferencial

Capítulo 8 de 10

La regresión a la media

Matemática y estadística 1085 palabras artículo suelto ↗

La regresión a la media es el hecho de que, cuando dos medidas están correlacionadas pero no perfectamente, los casos extremos en la primera tienden a ser menos extremos en la segunda. Los hijos de padres muy altos son altos, pero menos que sus padres; los alumnos que sacan la mejor nota en un examen sacan buena nota en el siguiente, pero rara vez la mejor; el hospital con más muertes este año tendrá probablemente menos el año que viene sin que nadie haya hecho nada. No es una fuerza, ni una tendencia hacia la mediocridad, ni un castigo por destacar. Es una consecuencia aritmética de que una parte de cualquier medida sea azar, y sin embargo lleva siglo y medio produciendo conclusiones equivocadas en la medicina, la educación, la economía y el deporte.

Francis Galton la descubrió midiendo estaturas. En 1886 publicó una tabla con 928 hijos adultos de 205 parejas inglesas, en la que a cada hijo se le asignaba la estatura media de sus padres —con la de la madre multiplicada por 1,08 para hacerla comparable con la del padre— y comprobó que los hijos de padres que medían 5 centímetros más que la media medían, de media, unos 3 centímetros más, dos tercios del exceso. La figura de esta página dibuja exactamente esa tabla, pasada a centímetros. La recta que mejor ajusta la estatura de los hijos a la de los padres tiene pendiente 0,65, y los círculos blancos, la media de los hijos para cada grupo de padres, se apartan de la diagonal en las dos puntas: los hijos de los padres más altos son más bajos que ellos, y los de los más bajos, más altos.

Interactivo Las 928 familias de Galton, cada punto un hijo adulto, con un poco de ruido para separar los que caen en la misma casilla. La diagonal gris es «medir lo mismo que los padres»; la recta naranja es la regresión. Mueve el deslizador para ver la media de los hijos de un grupo de padres. Pulsa «Predecir a los padres» y verás que la regresión funciona igual al revés: los padres de hijos altos son menos altos que sus hijos.

Galton lo llamó primero reversión y después regresión hacia la mediocridad, y pensó al principio que había descubierto una ley de la herencia, una fuerza que devolvía a cada generación hacia el tipo ancestral. Le costó darse cuenta de que el fenómeno no tiene nada que ver con la herencia: el botón de la figura que invierte la predicción lo demuestra. Si se toman los hijos más altos y se mira a sus padres, los padres son también menos altos que ellos; la regresión funciona igual hacia atrás en el tiempo, y ningún mecanismo biológico puede hacer que los hijos «tiren» de la estatura de sus padres. Stephen Stigler, historiador de la estadística, ha contado cómo Galton tardó años en pasar de esa intuición equivocada a la explicación correcta, que es puramente estadística, y cómo en el camino inventó el coeficiente de correlación y la recta de regresión, que heredaron el nombre de un fenómeno que ya no describen.

La explicación es esta. La estatura de una persona se puede pensar como una parte que comparte con sus padres y otra que no: alimentación, enfermedades, azar del desarrollo. Los padres excepcionalmente altos lo son en parte por la primera y en parte por la segunda, y solo transmiten la primera. Sus hijos reciben la parte compartida y una porción nueva de azar, que en promedio es cero, así que quedan más cerca de la media. Cuanto menor es la correlación entre las dos medidas, mayor la regresión; con correlación perfecta no habría ninguna, y con correlación cero la mejor predicción para cualquier hijo sería la media general, sea como sea el padre. En los datos de Galton la correlación es de 0,46 y la pendiente, la fracción del exceso que se conserva, de 0,65. La recta naranja de la figura es esa fracción.

El error que la regresión induce tiene nombre —la falacia de la regresión— y consiste en atribuir a una causa lo que la aritmética garantizaba. Harold Hotelling lo denunció en 1933 en una reseña célebre del libro El triunfo de la mediocridad en los negocios, en el que el economista Horace Secrist había mostrado, con cientos de tablas, que las empresas más rentables de un año eran menos rentables años después, y las menos rentables más, y lo había interpretado como una tendencia de la competencia a igualar a todos. Hotelling señaló que las tablas probaban lo mismo que probarían las estaturas de Galton, es decir, nada, y que el mismo libro se podía haber escrito leyendo el tiempo hacia atrás. En medicina el problema es cotidiano: un paciente al que se trata porque su tensión salió alta en una medida tendrá una medida más baja en la siguiente aunque el tratamiento no haga nada, porque parte de la primera era ruido. Martin Bland y Douglas Altman lo explicaron en 1994 a los lectores del British Medical Journal y concluyeron que la única defensa es el grupo de control, que regresa lo mismo sin recibir el tratamiento.

Daniel Kahneman ha convertido el fenómeno en una pieza central de su explicación de por qué el juicio intuitivo falla. Cuenta que instructores de vuelo de la aviación israelí estaban convencidos de que reñir a un cadete tras una mala maniobra mejoraba la siguiente, y de que felicitarlo tras una buena la empeoraba, y que ambas cosas eran ciertas y ninguna se debía a ellos: tras una maniobra excepcionalmente mala lo esperable es una mejor, y tras una excepcionalmente buena, una peor, con instructor o sin él. La misma lógica explica la «maldición» de las portadas deportivas, la caída de las segundas temporadas y el desengaño con el fichaje estrella que venía de su mejor año. La mente busca una causa para cada cambio, y la regresión produce cambios que no tienen ninguna.

La lección de la figura está en el deslizador. Elegir a los padres de 184 centímetros y ver que sus hijos miden de media 182,6 no dice nada sobre los genes de esas familias; dice que los padres de 184 fueron seleccionados por ser altos y que parte de su altura no era transmisible. Cualquier vez que se seleccione un grupo por su valor extremo en una medida —los peores colegios, los mejores fondos de inversión, las carreteras con más accidentes— y se vuelva a medir, el grupo habrá mejorado o empeorado hacia la media sin que eso pruebe la eficacia de lo que se haya hecho entre tanto. Galton lo descubrió con cintas métricas en 1886, y sigue siendo la trampa más común en la lectura de datos.

Desviación típica (desviación estándar) – Recta de regresión de mínimos cuadrados – Sesgo del superviviente – Correlación espuria (correlación espúrea)

Capítulo 9 de 10

Ley de Goodhart

Matemática y estadística 1149 palabras artículo suelto ↗

La ley de Goodhart establece que toda regularidad estadística observada tiende a desaparecer en cuanto esa medida se convierte en objetivo de una política. La formuló el economista británico Charles Goodhart en 1975, cuando era asesor del Banco de Inglaterra, para explicar por qué los agregados monetarios dejaban de predecir la inflación justo cuando el banco central empezaba a fijarles un objetivo. Su tesis es contraintuitiva: el problema no es que los indicadores sean malos, sino que funcionan precisamente mientras nadie apunta a ellos; medir bien y gobernar por el número son, a largo plazo, actividades incompatibles.

El caso original está documentado en detalle. A mediados de los setenta la relación entre la cantidad de dinero en circulación y el nivel de precios era uno de los hechos estilizados más sólidos de la macroeconomía británica, y Goodhart la enunció con precisión de epitafio: cualquier regularidad estadística observada tiende a colapsar cuando se ejerce presión sobre ella con fines de control. Reino Unido fijó objetivos para el agregado £M3 en 1976, dentro del programa acordado con el Fondo Monetario Internacional, y los reforzó en 1980 con la Estrategia Financiera a Medio Plazo; a mediados de los años ochenta la relación con la inflación se había roto y el objetivo se abandonó. El mismo año en que Goodhart publicaba, Robert Lucas formulaba la crítica gemela para toda la econometría: una política predicha por un modelo cambia el comportamiento que el modelo daba por fijo. Y en 1976 también, Donald T. Campbell enunciaba la versión para las ciencias sociales: cuanto más se usa un indicador cuantitativo para decidir, más presiones de corrupción sufre y más se corrompe. La frase que hoy circula —«cuando una medida se convierte en objetivo, deja de ser una buena medida»— no es de Goodhart sino de la antropóloga Marilyn Strathern, escrita en 1997 a propósito de las auditorías universitarias británicas, que pagaban valoraciones de los departamentos según lo que podía contarse en ellos: publicaciones, doctorandos, expedientes. Strathern observó que la medida pensada para reflejar la calidad investigadora había pasado a definirla.

El mecanismo es simple y no requiere mala fe. Un indicador es útil porque correlaciona con algo que nos importa pero que no sabemos medir directamente: el número de altas hospitalarias con la salud de la población, las notas con el aprendizaje, los delitos esclarecidos con la seguridad. Esa correlación se sostiene mientras nadie tenga interés en manipularla. En el momento en que el indicador determina presupuestos, ascensos o supervivencia laboral, los agentes optimizan el indicador y no la cosa medida, y el vínculo entre ambos se rompe. El indicador sigue subiendo; lo que pretendía representar, no. Hay tres formas de rotura que conviene distinguir: empujar el sistema fuera del rango en que la medida estaba calibrada; intervenir sobre la medida misma en lugar de sobre la causa, rompiendo el mecanismo; y, con incentivos suficientes, falsificarla. Manheim y Garrabrant publicaron en 2019 una taxonomía formal de estas variantes, fruto de un giro curioso: la ley de Goodhart, nacida en un banco central, acabó siendo uno de los problemas centrales de la seguridad en inteligencia artificial, donde todo sistema entrenado optimizando una métrica acaba buscando las rendijas de la métrica.

Las manifestaciones documentadas son abundantes y siempre del mismo tipo. Campbell mismo las clasificó en 1976: cuanto más alto es el uso social de un indicador, mayor la tentación de tratar a quienes lo reportan y de jugar con él, y sus ejemplos eran las notas escolares —que enseñan a aprobar exámenes, no a saber— y las estadísticas policiales, que mejoran si se deja de denunciar. En el sistema sanitario británico, el objetivo de que ningún paciente esperase más de cuatro horas en urgencias —introducido en 2004 con una exigencia del 98%— produjo pacientes retenidos en ambulancias a la puerta del hospital, porque el reloj empezaba a contar en el ingreso; el objetivo se relajó al 95% en 2010. En la guerra de Vietnam, el recuento de cadáveres enemigos como medida de progreso militar generó un incentivo directo a contar mal, y los historiadores lo señalan como uno de los datos menos fiables de toda la contabilidad bélica americana. Cuando Wells Fargo premió el número de productos vendidos por cliente, aparecieron cuentas abiertas sin que el cliente lo supiera: el banco reconoció en 2016 millones de ellas y pagó una multa de 185 millones de dólares. Y el ejemplo canónico —una fábrica soviética que, medida en unidades, produce clavos diminutos, y medida en toneladas, produce un solo clavo gigantesco— probablemente sea apócrifo, pero describe con exactitud la lógica del fenómeno.

El catálogo se completa con los incentivos mal dirigidos de la historia colonial y estatal. La anécdota del «efecto cobra» —una supuesta recompensa británica por cada cobra muerta en la India que acabó incentivando su cría— es difícil de documentar; su versión verificable ocurrió en Hanói en 1902, cuando el gobierno colonial francés pagaba por ratas entregadas para combatir una plaga y descubrió granjas de ratas criadas para cobrar la prima, y el programa se canceló a mitad. China cometió en 1958 una versión sin mecanismo de mercado: la campaña de las Cuatro Plagas declaró al gorrión enemigo del grano, la población lo exterminó en buena parte del país, y las langostas, ya sin depredador, contribuyeron a la peor hambruna de su historia. El patrimonio tiene nombre propio: la ley de Goodhart gobernaba colonias y planes quinquenales antes de que nadie la nombrara.

Tres encantadores de serpientes con una cobra en un cesto, India, hacia 1890-1900
Fig. 1 Encantadores de serpientes con una cobra, India, entre 1890 y 1900 (Frank and Frances Carpenter Collection, Library of Congress). La anécdota del «efecto cobra» —una supuesta recompensa por cada cobra muerta que acabó incentivando su cría— es difícil de documentar; su versión verificable ocurrió en Hanói en 1902, con ratas en lugar de cobras. La moraleja es la de la ley de Goodhart en versión zoológica: la recompensa mide la cola entregada, no el animal que falta en la calle.Frank and Frances Carpenter Collection · 1890 · Dominio público · Wikimedia Commons

A ese catálogo se le debe aplicar la objeción seria, no el consuelo fácil. Sin indicadores no hay gestión posible: un hospital, una escuela o un banco central que renuncie a medir gobernará a ciegas, y el sustituto habitual —el juicio experto— es opaco, no auditable y tan manipulable como la cifra, solo que sin recursos para defenderse. La ley de Goodhart no condena la medición sino la ingenuidad sobre su caducidad. De ahí las estrategias defensivas habituales: usar varios indicadores que solo puedan mejorarse a la vez mejorando el fenómeno de fondo, rotarlos o mantener parte de ellos ocultos, auditar por muestreo con procedimientos distintos a los que generan la cifra oficial, y separar la medición del sistema de incentivos. Ninguna es gratuita, y todas admiten la misma objeción recursiva: quien conoce la defensa la incorpora a su optimización.

La conclusión práctica es incómoda para toda burocracia de objetivos —y para la gestión por indicadores en general—: no existe la métrica que no se pueda cocinar, solo la métrica que todavía no compensa cocinar. La ley sigue siendo útil porque señala el momento en que conviene dejar de confiar en una cifra que lleva años siendo objetivo: cuando el indicador mejora sin pausa mientras todo lo que no se mide empeora, la pregunta ya no es si la medida es buena, sino qué está comprando exactamente quien la reporta.

Sesgo de selección – Muestra sesgada – Profecía autocumplida – Efecto cobra – El problema de la inducción

Capítulo 10 de 10

Efecto Hawthorne

Metodología 830 palabras artículo suelto ↗

El efecto Hawthorne es la alteración del comportamiento de las personas por el hecho de saber que están siendo observadas. Su nombre viene de la planta Hawthorne de la Western Electric, en Cicero (Illinois), donde entre 1924 y 1932 se llevó a cabo una serie de estudios sobre las condiciones de trabajo cuyos resultados dieron origen a la sociología industrial, a la escuela de relaciones humanas en la gestión de empresas y, de rebote, a una advertencia metodológica que afecta a cualquier investigación con seres humanos.

Los experimentos originales pretendían medir cómo influía la iluminación en la productividad. El resultado desconcertó a los investigadores: la producción aumentaba al subir la intensidad de la luz, y volvía a aumentar al bajarla. Estudios posteriores en la misma planta —el más citado, el de la sala de montaje de relés— alteraron horarios, pausas, sistemas de pago y supervisión, y encontraron una y otra vez mejoras que no se correspondían con la dirección del cambio. La interpretación que se impuso, asociada a Elton Mayo y a Fritz Roethlisberger, fue que el factor decisivo no era ninguna de las variables físicas sino la atención recibida: las trabajadoras del grupo experimental sabían que su rendimiento se estaba estudiando, habían sido seleccionadas, consultadas y tratadas de un modo distinto, y respondían a eso. De ahí la conclusión de la escuela de relaciones humanas: los factores sociales y psicológicos del trabajo pesan más que los físicos, tesis que desplazó al taylorismo como marco dominante de la gestión.

Vista de la planta Hawthorne de la Western Electric Company en 1925
Fig. 1 La planta Hawthorne de la Western Electric en 1925, en plena serie de experimentos: unas cuarenta mil personas trabajaban allí fabricando material telefónico. Las conclusiones que se extrajeron de aquel recinto —que el rendimiento depende más de las relaciones y de la atención que de la iluminación o de las pausas— reorganizaron la teoría de la gestión durante medio siglo.Western Electric Company · 1925 · Dominio público · Wikimedia Commons

La reevaluación posterior ha sido demoledora con el estudio y, curiosamente, benévola con el concepto. Los datos originales se conservaron y varios equipos los han vuelto a analizar con métodos actuales. Los resultados: en el experimento de la iluminación, la documentación es tan escasa que no permite sostener casi nada; en la sala de relés, los aumentos de productividad se explican en buena medida por factores mundanos que la interpretación clásica pasó por alto —la sustitución de dos trabajadoras del grupo por otras más productivas a mitad del experimento, el aprendizaje acumulado a lo largo de meses, el cambio de sistema de incentivos, y el hecho de que la producción subía los lunes tras el descanso independientemente de cualquier manipulación—. Un reanálisis de los datos de iluminación publicado en 2011 encontró un patrón compatible con el efecto, pero muy pequeño y confundido con la estacionalidad. La conclusión razonable es que el efecto Hawthorne, tal como se enseña, no fue demostrado en Hawthorne: es un concepto útil que quedó bautizado con el nombre de un estudio que no lo probaba.

Lo que sí está bien establecido es el fenómeno general, comprobado en cientos de contextos distintos y por eso digno de conservar el nombre. Los participantes de un experimento no son observadores pasivos: intentan averiguar qué se espera de ellos y actúan en consecuencia, lo que en la literatura se llama efecto de las características de la demanda. Los pacientes de un ensayo clínico cumplen mejor el tratamiento y declaran mejorías que no se corresponden con marcadores objetivos. Los conductores reducen la velocidad ante una cámara y aceleran después. Los profesores enseñan distinto cuando hay un inspector en clase. Y en los indicadores de gestión, el fenómeno se combina con la ley de Goodhart para producir el resultado habitual: lo que se mide mejora, y lo que se pretendía medir no necesariamente.

De ahí una batería de precauciones metodológicas que la investigación aplicada ha incorporado. Los diseños con doble ciego impiden que participantes e investigadores sepan quién recibe qué. Los grupos de control activo reciben una intervención placebo con la misma cantidad de atención, precisamente para que el efecto Hawthorne actúe igual en ambos brazos y se cancele. Los períodos de familiarización dejan pasar el tiempo suficiente para que la novedad de ser observado se agote. El uso de datos administrativos o de registro en lugar de autoinformes evita la reactividad al cuestionario. Y la observación no obtrusiva —datos recogidos sin que el sujeto lo note, con sus propios problemas éticos— es la solución extrema. Ninguna de ellas es perfecta, y el efecto es una de las razones por las que las intervenciones sociales y educativas rinden con frecuencia mucho menos al escalarse que en el estudio piloto: en el piloto, la atención del equipo investigador formaba parte del tratamiento.

Conviene señalar por último la ambigüedad conceptual que arrastra la etiqueta. Se ha usado para nombrar cosas distintas: la reactividad a la observación, la mejora por la novedad, el deseo de complacer al investigador, el efecto de la atención social e incluso el placebo. Esa amplitud lo ha hecho popular y a la vez lo ha vuelto poco informativo, porque cada uno de esos mecanismos exige un control diferente. En una discusión seria conviene nombrar cuál se sospecha en lugar de invocar el conjunto, y recordar que el nombre remite a una planta de teléfonos donde probablemente ocurrió otra cosa.

Sesgo de confirmación – Ley de Goodhart – Validez externa – Sesgo de selección – Indicador (definición)

Este itinerario ordena artículos de la enciclopedia; cada uno vive también suelto, con sus fuentes y su historial. ¿Le falta un capítulo o le sobra uno? Dínoslo.

Todos los itinerarios →