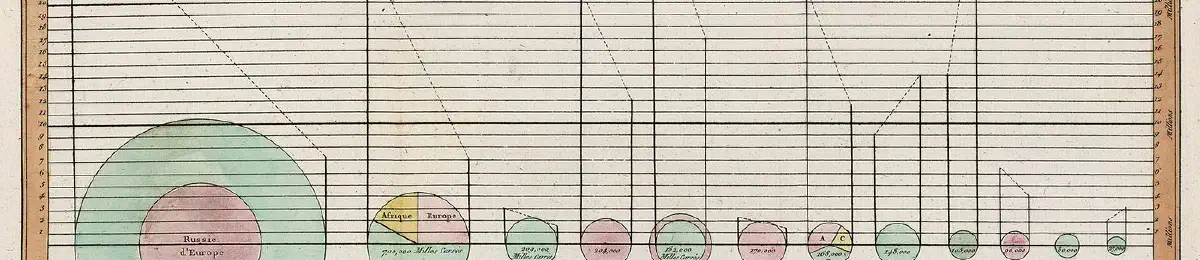
Los primeros gráficos de sectores, del Statistical Breviary — Estadística descriptiva, de cero
William Playfair, 1801 · Public domain · Wikimedia Commons
Itinerarios / básico

Estadística descriptiva, de cero

Diecisiete piezas para describir cualquier conjunto de datos, de qué es la estadística a la desviación típica, en el orden en que se aprenden y sin nada previo.

17 capítulos · 8,958 palabras · 45 min · cada capítulo es un artículo de la enciclopedia

El itinerario de entrada del sitio. No supone nada: empieza por qué es la estadística y termina en la desviación típica. Es el único que conviene leer entero y en orden, porque cada capítulo usa el anterior.

Cada pieza viene con la advertencia que suele faltar. Antes de recoger un dato hay que escribir quién entra en la población y quién queda fuera. Una muestra es representativa por haberse elegido al azar, no por ser grande. Los errores que no son de muestreo, como la gente que no contesta o no dice la verdad, no los corrige ninguna fórmula y suelen ser mayores. Y antes de contar hay que decidir qué cosas cuentan como la misma cosa.

Para resumir unos datos, primero se miran, y un histograma dice más que cualquier número. Media, mediana y moda pueden caer lejos unas de otras. Cuando la media y la mediana se separan, la distribución tiene algo que contar: con sueldos o con precios de pisos, la mediana suele describir mejor el caso típico. La varianza está en unidades al cuadrado, y por eso en la práctica se usa la desviación típica, que vuelve a las unidades de partida.

La distribución normal cierra con una cautela. La campana no es la forma del mundo, sino la de las sumas de muchas cosas pequeñas, y solo sirve cuando la cantidad se parece a una suma.

Después, Leer los datos sin que te engañen es la continuación natural.

Capítulo 1 de 17

¿Qué es la estadística?

Matemática y estadística 787 palabras artículo suelto ↗

El término estadística tiene dos acepciones. En la primera designa un conjunto de datos, como cuando se habla de “las estadísticas del paro” o “las estadísticas electorales”. En la segunda, que es la que interesa aquí, designa la disciplina que estudia cuantitativamente conjuntos de datos: el conjunto de técnicas para recoger y analizar adecuadamente datos sobre un fenómeno variable, con el fin de identificar en ellos estructuras, tendencias y regularidades y formular conclusiones de carácter general.

Como toda disciplina, se define por su objeto material y su objeto formal. El objeto material son los datos y los conjuntos de datos, es decir, aquello que se estudia. El objeto formal es lo que se hace con ellos: resumirlos, buscar patrones y extraer conclusiones generales.

El objeto de estudio: fenómenos variables

La estadística trabaja con fenómenos que toman valores distintos según el elemento o el momento observado: las calificaciones de un grupo de alumnos, los ingresos de las familias o la temperatura diaria. No estudia magnitudes fijas, como la hora de salida de un autobús, la nota mínima para aprobar o la renta máxima para recibir una ayuda, que no varían y por tanto no tienen nada que resumir.

Una disciplina de conclusiones generales

Las conclusiones estadísticas describen tendencias, no casos individuales. Si la nota media de una clase es un 7, eso no significa que todos hayan aprobado. Indica un valor central en torno al cual habrá siempre alumnos por encima y por debajo. La estadística tampoco analiza casos aislados para sacar conclusiones sobre ellos, aunque pueda ayudar a hacer predicciones. El refrán vasco lo resume bien: enara batek ez du udaberria egiten, una golondrina no trae la primavera.

Por otra parte, los resultados exijan interpretación. La estadística no es una calculadora: saber leer e interpretar lo que producen los cálculos forma parte del trabajo estadístico.

Estadística e inducción

Existen dos grandes métodos para construir conocimiento científico:

  • La deducción parte de axiomas o enunciados de partida y obtiene otros mediante razonamiento lógico. Es el método característico de la matemática.
  • La inducción parte de casos individuales y particulares para construir leyes generales, normalmente admitiendo cierta variabilidad.

La estadística es el método de la inducción. Por ejemplo, si al reunir datos de todos los países se observa que, cuanto mayor es el peso de la industria, menor tiende a ser el desempleo, se puede concluir que la industria es un sector importante para reducir el paro. Esa conclusión general procede de casos concretos. Estudia datos individuales para extraer conclusiones sobre un fenómeno o una población completa.

Estadística e investigación nomotética

Ante un fenómeno cabe adoptar dos enfoques:

  • La investigación ideográfica estudia casos particulares, bien por su interés intrínseco, bien porque se cree que sus conclusiones pueden extenderse a un fenómeno más amplio. Un ejemplo sería analizar el mercado de la vivienda de una ciudad concreta en un año determinado.
  • La investigación nomotética estudia el fenómeno en toda su diversidad y variabilidad, examinando el conjunto de casos que lo componen para obtener conclusiones generales.

La estadística pertenece al segundo enfoque: es la técnica que permite abordar conjuntamente todos los casos de un fenómeno.

La necesidad de resumir: el mapa de Borges

Reunir datos cuesta dinero, y acumular demasiados no aclara el fenómeno, sino que lo enturbia. El relato de Jorge Luis Borges Del rigor en la ciencia ilustra este problema. En él, los cartógrafos de un imperio levantan un mapa tan detallado que coincide punto por punto con el territorio y tiene su mismo tamaño. Resulta inútil y acaba abandonado y en ruinas.

Un conjunto de datos en bruto es como ese mapa: una copia de la realidad sin valor por sí misma. Conocer la realidad exige resumirla, y esa es la función esencial de la estadística: simplificar los fenómenos variables y recoger sus tendencias, regularidades y demás información relevante. Por ello conviene definir de antemano el objetivo del estudio y reunir solo los datos necesarios, ni más ni menos.

Ramas y campos de aplicación

La estadística puede aplicarse a cualquier ámbito del conocimiento, desde la astronomía hasta la comparación cuantitativa del estilo de distintos escritores. Esta universalidad ha llevado a describirla como una mathesis universalis, una ciencia universal. Aun así, cada campo emplea métodos propios, y algunos han recibido nombre específico:

  • Econometría: estadística aplicada a la economía.
  • Bioestadística: la que se desarrolla en biología y medicina.
  • Epidemiología: estudia la frecuencia de las enfermedades.
  • Psicometría: estadística aplicada a la psicología, que estudia, entre otras cosas, cómo construir tests.
  • Demografía: analiza las poblaciones y su evolución.
  • Astrometría: estadística aplicada a la astronomía.
  • Geoestadística: se aplica a la meteorología, la climatología, la geología y otras ciencias de la Tierra, y analiza sobre todo datos espaciales y temporales.
Capítulo 2 de 17

Población estadística

Matemática y estadística 678 palabras artículo suelto ↗

Quizás estés buscando más bien; Población (demografía)

Una población estadística es el conjunto de todos los elementos sobre los que se quiere saber algo: los trabajadores de una región, los votantes inscritos de un país, las piezas de un lote industrial, los pacientes que podrían recibir un fármaco. La definición parece un mero trámite previo pero en realidad es la decisión que condiciona todo lo demás. Y es que la mayor parte de los desastres estadísticos no son errores de cálculo sino de frontera; se midió con enorme precisión un conjunto que no era el que importaba. De ahí que los tratados serios dediquen más esfuerzo a delimitar la población que a elegir la fórmula con la que después se resume.

La delimitación exige distinguir tres planos que en la práctica se confunden. La población diana es el conjunto ideal sobre el que se quiere concluir; la población accesible es el que realmente se puede alcanzar con el marco disponible —el censo electoral, el registro de colegiados, la base de clientes—; y el marco muestral es la lista concreta de la que se extraerán los elementos. Cada paso introduce un filtro, y si la pregunta se formula sobre la primera y los datos llegan de la última, la conclusión responde a una pregunta distinta de la planteada. La homogeneidad es el otro requisito clásico: si se quiere estudiar el número de trabajadores por empresa, conviene definir poblaciones por sector, porque el comercio minorista y la industria no comparten escala, y mezclarlos produce un promedio que no describe bien a ninguno. Una población mal homogénea no es una población grande: es dos poblaciones rotas.

El caso que mejor muestra el precio de una frontera mal trazada es la Literary Digest en las elecciones estadounidenses de 1936. La revista envió cuestionarios a unos diez millones de personas —listas de propietarios de automóviles, abonados al teléfono, socios de clubes y sus propios lectores— y recibió de vuelta unos 2,4 millones, el mayor sondeo que nadie había intentado. Predijo la victoria del republicano Alf Landon sobre Franklin D. Roosevelt. Roosevelt ganó con el 60,8 % del voto popular y triunfó en cuarenta y seis de los cuarenta y ocho estados. El error no fue de tamaño, que era colosal, ni de respuesta, que fue masiva: fue que la población definida por aquellas listas, en plena Depresión, estaba sesgada hacia un sector determinado de la población diana.

Conviene retomar aquí una distinción que los tratados clásicos cuidan y la práctica moderna suele saltarse: la de población finita e infinita. Una población es finita cuando sus elementos se pueden enumerar en principio, como los votantes inscritos o las piezas de un lote; es infinita cuando no admite lista posible, como las mediciones repetibles de un mismo instrumento, que podrían producirse sin límite. La distinción no es filosófica: condiciona los métodos. Con poblaciones finitas se puede muestrear sin reemplazo y el error muestral se reduce al agotar la población, de modo que un censo exacto es en principio posible; con infinitas, el censo es imposible por definición y toda conclusión es ya inferencia. La estadística moderna unificó ambos casos imaginando la muestra como extracción de una distribución teórica —la superpoblación—: incluso cuando el censo completo existe, se le trata como una realización posible entre muchas.

Ninguna de estas objeciones anula el concepto de población. La población estadística sigue siendo el primer paso de cualquier investigación empírica, y escribirla antes de recolectar un solo dato —quién entra, quién queda fuera, con qué criterio de homogeneidad, mediante qué marco— sigue siendo la mejor protección contra el error más caro de todos: el que sale impecable de los cálculos y no responde a la pregunta. Por ejemplo, las Naciones Unidas cuidan hoy ese estándar: sus proyecciones de población mundial se publican con definiciones armonizadas de residente y de empadronamiento precisamente para que las fronteras sean comparables entre países, porque una población definida de otro modo no solo se mide distinto: mide otra cosa.

Universo (estadística) – Población objetivo (población diana) – Población y muestra – Censo estadístico – Muestra estadística

Capítulo 3 de 17

Muestra estadística

Matemática y estadística 1109 palabras artículo suelto ↗

Una muestra estadística es un subconjunto de elementos extraídos de una población que se usa como base para inferir las características de esta. Representa la idea más fecunda de la estadística moderna: que se puede saber algo preciso sobre millones de elementos sin mirarlos, siempre que los pocos que se miran se hayan elegido de la manera correcta. Si bien una muestra grande representa mejor la población a igual de condiciones que una muestra pequeña, debe subrayarse que el valor fundamental de una muestra no depende de su tamaño sino de su procedimiento de selección. Una muestra pequeña y elegida al azar vale infinitamente más que una gigante y autoseleccionada, porque el azar, y solo el azar, permite medir el error que se comete.

De la población a la muestra y vuelta: solo la selección al azar permite medir cuánto se equivoca la inferencia

Las razones para muestrear en lugar de censar son las de siempre: coste, tiempo e imposibilidad material. Medir la resistencia de todas las piezas destruiría todas las piezas; entrevistar a todos los votantes antes de las elecciones tomaría más que el escrutinio; listar todos los especímenes de una especie vegetal es literalmente imposible, porque la lista crece mientras se redacta. En esos casos la muestra no es un compromiso: es la única vía de conocimiento. Pero históricamente la primera pregunta no fue cuántos elementos tomar, sino cómo elegirlos.

Durante siglos la respuesta fue el muestreo por cuotas: fijar en la muestra las mismas proporciones observadas en la población (edad, sexo, clase) y luego dejar que los encuestadores escojan dentro de cada casilla a quien les resulte accesible. Fue el método con el que George Gallup construyó su reputación en 1936: con unas cincuenta mil entrevistas distribuidas por cuotas, predijo la victoria de Roosevelt. Sin embargo, el muestreo por cuotas tiene un defecto estructural ya que no permite cuantificar el error muestral, el error que se comete al estimar características de la población a través de la muestra; solo una muestra aleatoria, selección aleatoria de unidades, con probabilidades conocidas, permite calcular cuánto puede desviarse la muestra del conjunto. El azar no se usa porque sea equilibrado —en muestras pequeñas puede salir muy desequilibrado—, sino porque su comportamiento es matemáticamente descrito: con una muestra aleatoria de mil personas, el margen de error típico de una proporción ronda el tres por ciento, con independencia de si la población tiene diez mil o cien millones de elementos. Así, en una muestra aleatoria simple de tamaño nn, el error típico de una proporción es p(1−p)/n\sqrt{p(1-p)/n}, que en el peor caso, p=0,5p = 0,5, da 1/(2n)1/(2\sqrt{n}): con n=1.000n = 1.000, aproximadamente 0,016 a cada lado, el famoso margen de «más menos tres puntos» al 95 % de confianza independientemente del tamaño de población, porque lo que importa es la fracción de variabilidad que mil observaciones aportan, no la fracción de la población que representan. De ahí que los diseños más usados sean refinamientos del azar puro: el muestreo estratificado divide la población en grupos internamente homogéneos y sortea dentro de cada uno, garantizando que ningún grupo se quede fuera por azar; el muestreo por conglomerados sortea unidades naturales —barrios, escuelas, manzanas— por lo barato y luego mide todo dentro de las elegidas; y el muestreo polietápico encadena ambos.

A las objeciones clásicas se han sumado dos problemas modernos. El primero es la caída vertiginosa de la tasa de respuesta: según algunos estudios, responder a encuestas telefónicas pasó de atraer al 36 % de los contactados en 1997 al 6 % en 2018, y con esa deserción nadie puede garantizar que el 6 % que responde se parezca al 94 % que no. Hay que distinguir aquí dos errores que se confunden en los titulares: el error de muestreo, que el azar permite medir, y el error ajeno al muestreo —no respuesta, mentira, mal registro—, que no se calcula con ninguna fórmula y suele ser mayor. Un margen de error de tres puntos puede acompañar a un sesgo de diez. El segundo es que el muestreo por cuotas sobre paneles de internet conlleva sesgo de selección, porque las personas que usan internet tienen tendencias diferentes en la variable de estudio respecto a las personas que no usan internet.

La conclusión no es que muestrear esté acabado, sino lo contrario. Con un marco decente y selección aleatoria, muestras de apenas unos miles de personas bastan para estimar elecciones nacionales con dos o tres puntos de margen, algo que ningún censo informal logra. La muestra representativa no es la que tiene muchos elementos: es la cuyo procedimiento de elección permite saber cuánto puede equivocarse.

Tamaño muestral (tamaño de la muestra) – Error de muestreo (error muestral) – Muestreo estadístico – Muestra representativa – Muestra sesgada – Censo estadístico

Capítulo 4 de 17

Error estadístico

Matemática y estadística 115 palabras artículo suelto ↗

El error estadístico es un término general que hace referencia a la variabilidad y error subyacentes en los datos y resultados estadísticos. Más específicamente, incluye de forma especial dos fuentes de error: por un lado, el error aleatorio, esto es, la aleatoriedad propia de multitud de fenómenos expresada a través de mediciones variables, que se traduce en la aparición de variables estadísticas y que viene expreada en los modelos probababilísticos a través de la perturbación aleatoria; por otro lado, el error muestral, el error que aparece cuando se toma una muestra de elementos en lugar de la población de estudio en su totalidad y se extrapolan los resultados obtenidos del análisis de la muestra a la población.

Error de cobertura – Estadísticos muestrales – Tasa (estadística) – Muestra representativa

Capítulo 5 de 17

Estadística descriptiva y estadística inferencial

Matemática y estadística 133 palabras artículo suelto ↗

La estadística descriptiva o estadística deductiva tiene como objetivo la exploración y descripción de un conjunto de datos de una muestra para analizar sus características generales, sin entrar a analizar en que medida y con qué error pueden extrapolarse esas conclusiones a la población correspondiente o con qué seguridad puede afirmarse que resultan diferentes de otros conjuntos de datos. Utiliza para ello gráficos y técnicas cuantitativas de carácter básico, accesibles a la gente corriente.

La estadística inferencial, inferencia estadística o estadística inductiva persigue determinar en que medida y con qué error muestral pueden inferirse o extrapolarse conclusiones del análisis de datos de una muestra o serie limitada de datos a la población correspondiente. Utiliza para ello la teoría de la probabilidad y herramientas matemáticas más complejas, de comprensión más difícil para la gente corriente.

Estadística inductiva – Estadísticos descriptivos – Metodología descriptiva

Capítulo 6 de 17

Escala de medida (escala de medición)

Matemática y estadística 109 palabras artículo suelto ↗

Una escala de medida, escala de medición o nivel de medición es una medida (consultar además: medición) que se asigna un valor a un conjunto de objetos o sujetos, de entre una serie de valores, números, modalidades o categorías. de forma que se hace posible la comparación entre los diferentes objetos considerados en un estudio. Existen diferentes tipos de niveles de medida que permiten diferentes tipos de comparación entre objetos: la escala nominal, que permite distinguir entre objetos; la escala ordinal, que permite ordenarlos; la escala de intervalo, que permite establecer la distancia absoluta entre objetos y la escala de razón, que permite establecer la distancia relativa entre objetos.

Escalas numéricas (estadística) – Variable ordinal – Escalas categóricas – Variable cuantitativa

Capítulo 7 de 17

Variables estadísticas

Matemática y estadística 441 palabras artículo suelto ↗

Una vez fijadas los caracteres estadísticos de la población que se va a investigar, el siguiente paso es proceder a la medición de dichas características. Tras la elección de la escala de medida, la recogida de datos de las características de la población para los elementos que se han seleccionado da lugar a las denominadas variables estadísticas (puede interesarte además, variable, en general).

Según como se midan las características, se distinguen diferentes tipos de variables estadísticas que se diferencian fundamentalmente por los tipos de técnicas estadísticas que se pueden aplicar a ellas. Fundamentalmente se distinguen estos dos tipos de variables:

  • variables estadísticas cualitativas o categóricas, cuando en realidad no se mide una característica sino que se establece si la característica adopta o no una determinada categoría o modalidad; por ejemplo, el sexo de una persona (con las modalidades de masculino o femenino), su nivel educativo (básico, medio, superior). Los datos relativos a estas características en base a esas modalidades constituyen lo que se denomina una variable estadística cualitativa.
  • variables estadísticas cuantitativas, que surgen cuando se mide a través de una cantidad o magnitud la característica a estudiar; por ejemplo, cuando se recopilan datos sobre la rentas de los hogares en dólares. Los datos relativos a la renta en dólares constituyen lo que se denomina una variable estadística cuantitativa. Dentro de las variables estadísticas cuantitativas deben distinguirse:
    • variables estadísticas discretas, las que toman un número limitado de valores aislados (por ejemplo, el número de hijos por familia y el número de asignaturas suspendidas en un curso);
    • variables estadísticas continuas, las que toman un número muy grande o ilimitado de valores (por ejemplo, alturas de una población personas y  temperatura máxima diaria en una ubicación determinada).

Hay que señalar que las características no son en sí generalmente cualitativas o cuantitativas sin que ello depende de la escala de medida que se utilice para concretarla. Por ejemplo, a la hora de recoger datos sobre las rentas de hogares en una ciudad, se puede decidir distinguir simplemente entre las categorías o modalidades de rentas bajas, rentas medias y rentas altas, aunque con los límites siempre bien especificados, de modo que estaríamos ante una variable estadística cualitativa, más concretamente una variable ordinal; o también se puede optar por medir la renta exactamente a través de una unidad de cuenta (euros o dólares), en cuyo caso estaríamos ante una variable estadística cuantitativa.

Según otro criterio, las variables estadísticas pueden ser por otro lado variables unidimensionales, cuando recogen una única característica; variables bidimensionales, cuando la variable se refiere a dos características observadas sobre un mismo conjunto de elementos; o variables multidimensionales, cuando incluyen más de dos caracteres sobre el mismo conjunto de elementos.

Constante estadística – Variable estadística unidimensional – Variable cualitativa (variable categórica) – Característica cualitativa – Variable nominal

Capítulo 8 de 17

Frecuencia absoluta

Matemática y estadística 412 palabras artículo suelto ↗
Interactivo Las calificaciones del texto: 4, 5, 5, 6, 6, 6, 6, 7, 7, 8. Los cuatro botones cambian la frecuencia que dibujan las barras —absoluta, relativa, acumulada y acumulada relativa— y la tabla marca de dónde sale cada cifra. Con + y − se añaden o quitan alumnos; «Datos ×100» multiplica la clase y deja intactas las frecuencias relativas.

La frecuencia absoluta es el número de elementos de una distribución de frecuencias que toman un valor, pertenecen a una categoría o caen dentro de un intervalo concreto. Si diez alumnos eligen entre las optativas A, B y C, y cinco eligen A, la frecuencia absoluta de A es 5: nada más que un conteo, la operación más humilde de la estadística. Aunque contar parece la operación más inocente, es muy teorizada en estadística, porque antes de contar hay que clasificar, y clasificar es decidir qué cosas son la misma cosa. Un recuento es tan bueno como la categoría previa que lo hizo posible, y la mayoría de las discusiones serias sobre datos acaban siendo discusiones sobre cómo se cortó el mundo para poder contarlo.

Dos distinciones conviene fijar desde el principio, porque organizan todo lo que sigue. La frecuencia simple absoluta cuenta los elementos de cada valor: en las calificaciones 4, 5, 5, 6, 6, 6, 6, 7, 7, 8, la frecuencia del 6 es 4. La frecuencia acumulada absoluta cuenta cuántos elementos quedan en o por debajo de un valor al irse sumando en orden creciente: acumulada hasta el 5 son 3 alumnos, hasta el 6 son 7. La acumulada es la forma en que un conteo se convierte en posición, y de ella salen los cuantiles y la propia mediana. Y frente a ambas está la frecuencia relativa, el cociente entre la frecuencia absoluta y el tamaño muestral o total, que es la única forma honesta de comparar poblaciones de tamaño distinto: 5 sobre 10 y 500 sobre 1.000 son la misma frecuencia relativa y cuentan historias idénticas, mientras que las frecuencias absolutas 5 y 500 sin contexto no se pueden comparar ni siquiera para saber cuál es mayor en sentido estadístico. Ese cociente, tomado como estimación de la probabilidad de un suceso cuando el total crece, es la base de la interpretación frecuentista de la probabilidad que formalizaron Richard von Mises en 1919 y, con otros matices, toda la estadística del siglo XX: la probabilidad de que una moneda salga cara es, en esta lectura, el límite hacia el que tiende la frecuencia relativa de caras.

Las frecuencias absolutas se escriben en la tabla de frecuencias que sigue siendo el primer paso de toda exploración estadística seria, y es que el ordenar y contar sistemático de lo observado es lo que convierte datos en conocimiento.

Frecuencia simple (estadística) – Datos agrupados – Frecuencia relativa – Frecuencia de clase – Distribución de frecuencias

Capítulo 9 de 17

Distribución de frecuencias

Matemática y estadística 579 palabras artículo suelto ↗

En estadística, una distribución de frecuencias o distribución de datos, también llamada tabla de frecuencias o cuadro de frecuencias, es la presentación organizada y ordenada, en forma de tabla o como representación gráfica, de los diferentes valores que toma una variable estadística junto con la frecuencia de aparición, en forma de frecuencia absoluta o frecuencia relativa, de cada valor en la serie de datos correspondientes a una variable. De este modo, las distribuciones de frecuencias no son más que series de datos agrupados a partir de los datos aislados, cuando el número de datos es grande (por dar una cifra más o menos exacta, superior a 20 datos) y entre estos se dan repeticiones de valores.

Dependiendo de que la variable estadística sea cualitativa o cuantitativa, discreta o continua y del número de datos que conforman la variable, la distribución de frecuencias adoptará un formato u otro.

Distribución de frecuencias para variables cualitativas

Para una variable cualitativa, la distribución de frecuencias se construye agrupando los datos según las modalidades o categorías que se den y realizando para una de ellas el conteo de datos correspondiente y así obtener la frecuencia absoluta y/o la frecuencia relativa.

Ejemplo: En un instituto se ha realizado una encuesta entre los alumnos en las que entre otras cuestiones se ha preguntado por el tipo de carrera universitaria que pretenden estudiar (técnica (T), humanística (H), ciencias sociales (S), área biosanitaria (B), ciencias puras (C)), obteniendo la siguiente serie de datos:

T-T-S-B-S-S-S-S-T-T-B-B-C-T-B-T-T-C-S-C

La distribución de frecuencias resultante, en forma de tabla, es la siguiente:

Distribución de frecuencias del tipo de carrera elegido por cada alumno
Tipo de carreraFrecuencia absoluta (n)
Frecuencia relativa (f)
Técnica7
35%
Ciencias Sociales6
30%
Biosanitaria
4
20%
Ciencias Puras
3
15%
TOTALES
20
100%

En esta distribución de frecuencias cabe distinguir la variable estadística analizada (tipo de carrera), las modalidades o categorías (técnica, ciencias sociales, biosanitaria, ciencias puras), la frecuencia absoluta (n), calculada a través del conteo de datos para cada modalidad, y la frecuencia relativa, calculada como porcentaje de la frecuencia absoluta sobre el número total de datos (por ejemplo, para las carreras técnicas, 7/20=0.35=35%). Normalmente se ordenan las modalidades según su frecuencia de aparición, de mayor a menor, a no ser que aquellas puedan clasificarse de forma natural.

La distribución gráfica más habitual correspondiente a este tipo de distribución cualitativa es el diagrama de barras:

Diagrama de barras de la distribución de frecuencias relativas (en porcentaje) del tipo de carrera elegido por el alumnado.
Fig. 1 Diagrama de barras de la distribución de frecuencias relativas (en porcentaje) del tipo de carrera elegido por el alumnado.

Distribución de frecuencias para variables cuantitativas

En el caso de las variables cuantitativas, hay que distinguir entre variables cuantitativas discreta y variables cuantitativas continuas.

Cuando la variable es cuantitativa discreta, la distribución de frecuencias se construye agrupando y contando los datos para cada valor que muestra la variable, mostrando dichos valores de forma ordenada, y estableciendo para cada valor las frecuencias absolutas y relativas simple (que se denotan con las letras n y f, respectivamente), y si interesa, también las frecuencias absolutas y relativas acumuladas (denotadas con las letras N y F, respectivamente).

Por otro lado, cuando la variable es cuantitativa continua, se construye una distribución de datos agrupada en intervalos, de forma que en lugar de contar los datos para los valores aislados de la variable, se cuentan los datos que se sitúan en cada intervalo de clase, para determinar del mismo modo que en las variables cuantitativas discretas, las frecuencias absolutas y relativas simples y las frecuencias absolutas y relativas acumuladas.

Distribución de frecuencias agrupada en intervalos – Distribución de frecuencias acumuladas – Media aritmética para datos agrupados – Frecuencia acumulada – Comprobación de Charlier – Diagrama escalonado (diagrama de escalera)

Capítulo 10 de 17

Representacion gráfica de datos y variables estadísticas (visualizacion de datos, gráficos estadísticos, diagramas estadísticos)

Matemática y estadística 150 palabras artículo suelto ↗

La representación gráfica de datos o variables estadísticas es el recurso a diagramas de líneas, barras, puntos y formas geométricas simples para representar gráficamente variables estadísticas o más en general conjuntos de datos con el fin de realizar una exploración visual y poder extraer unas primeras conclusiones sobre sus características. La ventaja de su utilización consiste en su simple interpretación, de acuerdo al adagio que afirma que una imagen vale más que mil palabras.

El diagrama o gráfico estadístico a utilizar en cada caso dependerá de la naturaleza de los datos y del tipo de variable. Como primera aproximación, la utilización de gráficos estadísticos puede responder a esta clasificación:

1: VARIABLES CUALITATIVAS

2: VARIABLES CUANTITATIVAS

2.1: Variable cuantitativa discreta

2.2: Variable cuantitativa continua

2.2.1: Número de datos pequeño: Diagrama de puntos

2.2.2: Número de datos grande: Histograma, polígono de frecuencias, ojiva.

Diagrama de frecuencias – Representación gráfica – Variable estadística discreta y variable estadística continua – Diagrama acumulativo de frecuencias – Variable estadística unidimensional

Capítulo 11 de 17

Histograma

Matemática y estadística 1158 palabras artículo suelto ↗
Interactivo Los pesos de una muestra de 100 tomates en ocho intervalos de 20 gramos. Arrastra sobre las barras para contar cuántos tomates caen en un tramo: en el intervalo de 200 a 220 g hay 6. La línea discontinua marca el centro, unos 260 g, calculado con las marcas de clase; los botones pasan a frecuencias relativas o dibujan el polígono de frecuencias.

Un histograma o más exactamente un histograma de frecuencias es una representación gráfica de una variable estadística continua (es decir, que toma muchos diferentes valores) adecuada para aquellos casos en los que el tamaño de muestra o número de datos es alto, con generalidad puede decirse que mayor que 20, agrupando para ello los datos en intervalos de clase consecutivos y representando las frecuencias de dichos intervalos a través de barras contiguas. Por ejemplo, un histograma es un diagrama apropiado para representar las alturas o pesos de una muestra grande de jóvenes, o las rentas percibidas por una población de familias. No sería un gráfico adecuado para, por ejemplo, representar el número de hermanos por familia,  por ser en este caso la variable discreta (con pocos valores diferentes, sería más conveniente para esa situación un diagrama de barras) o los tiempos de una carrera de 1.500m de 12 atletas, por disponer en este caso de un número insuficiente de datos (sería más oportuno un diagrama de caja o diagrama de puntos).

Una muestra grande de datos referidos a una variable continua resulta difícil de interpretar por sí sola, ya que agregados individualmente, los datos constituirán un conjunto heterogéneo e irregular. Sin embargo, a partir de la agrupación de los datos en intervalos, el histograma, construido de forma adecuada, nos ayudará a conocer cómo se distribuyen los datos a lo largo de los intervalos, visualizando características de los datos como su tendencia central y su dispersión.

Conceptos relacionados: amplitud de clase, frecuencia de clase, límite de clase, marca de clase

El punto de partida: el número de intervalos

El punto de partida para la construcción de un histograma consiste en la determinación del número de intervalos de clase en los que se agruparán los datos. Para ello debe tenerse en cuenta que cuanto menor sea el número de intervalos de clase, mayor será la pérdida de información respecto a los datos originales. Más concretamente:

  • por un lado, un número excesivamente alto de intervalos, generalmente más de 15 o 20, no resumirá los datos de forma adecuada, de modo que la información resultante seguirá siendo igual o similarmente confusa a la que poseíamos con los datos originales  o no agrupados;
  • por otro lado, un número muy bajo, generalmente inferior a 5,  puede derivar en una excesiva simplificación o resumen de los datos, con la consiguiente pérdida de información relevante.

Se han establecido diferentes reglas o fórmulas para el cálculo del número de intervalos más adecuado, generalmente como función creciente del tamaño de la muestra. Entre estas, la más utilizada es la regla de Sturges que calcula el número de intervalos de clase kk de esta forma, redondeando el resultado al siguiente número entero:

k=ln⁡nln⁡2+1k=\cfrac{\ln n}{\ln 2}+1

Construcción de los intervalos

Una vez determinado el número de intervalos de clase en los que se van a agrupar los datos, los pasos a desarrollar son los siguientes:

  • se calcula el recorrido o rango R de los datos, es decir, la diferencia entre el valor mayor y el valor menor de los datos;
  • se divide el recorrido R entre el número de intervalos k, siendo el resultado la amplitud de clase teórica de cada intervalo de clase;
  • se redondea por exceso dicha amplitud a un número significativo, por ejemplo 10, 20, 50, …;
  • se multiplica dicha amplitud final por el número de intervalos, obteniendo de esta forma el recorrido de los intervalos del histograma;
  • el exceso de recorrido entre este recorrido final y el recorrido real se reparte de forma más o menos equitativa por debajo del valor menor de los datos y por encima del valor mayor (para mayor información, consulta amplitud de clase);
  • se comienza a construir los intervalos desde el límite inferior de clase del primer intervalo, que coincide con el valor inferior disminuido por el exceso de recorrido considerado, hasta llegar al último intervalo, formando en total kk intervalos.

Agrupamiento de los datos

Una vez construidos los intervalos, es hora de agrupar los datos en estos. Para ello debe tenerse en cuenta que por convenio, se supone que los intervalos de clase son  abiertos por la derecha y cerrados por la izquierda, es decir el intervalo de clase a-b se considera de esta forma:

[a,b)[a, b)

A veces para evitar dicha suposición y dejar claro qué dato entra en cada intervalo, estos se establecen de forma consecutiva pero sin valores coincidentes: por ejemplo, a la hora de agrupar edades pueden establecerse como intervalos de clase 0-4, 5-9, 10-14, 15-19, …

Recomendaciones generales sobre los intervalos

  • Los intervalos deben ser disjuntos, esto es, no deben solaparse.
  • Como regla general, los intervalos serán de amplitud constante, pero en ciertas situaciones es mejor que se de amplitud diferente.
  • Los extremos de los intervalos serán preferiblemente números redondos.

Ejemplo

Se han recogido los datos sobre la altura de 100 jóvenes del sexo femenino en una región (cm):

170 174 170 168 168 163 184 173 164 168 169 164 163 173 166 169 164 176 171 171 165 178 179 161 180 169 170 157 177 168 172 174 163 169 168 178 180 184 172 172 179 172 163 177 158 163 171 174 167 161 179 173 183 169 166 163 175 169 167 169 167 161 169 181 165 156 167 170 170 170 167 170 174 173 170 168 165 170 173 157 166 170 159 176 166 169 171 172 174 178 173 178 174 176 171 162 166 162 165 164

Buscamos los valores mínimo y máximo entre los datos: 156cm (mínimo)  y 184cm (máximo).

Calculamos el recorrido o diferencia entre los valores máximo y mínimo: R=184-156=28.

Aplicamos la regla de Sturges para calcular el número de intervalos más adecuado para este número de datos:

k=ln100ln2+1=7.64→8k=\cfrac{ln 100}{ln 2}+1=7.64 \rightarrow 8

Calculamos la amplitud teórica de cada intervalo dividiendo el recorrido entre el número de intervalos fijado. Dado que es conveniente que la amplitud de los intervalos sea un número redondo, redondeamos la amplitud teórica por exceso, para poder cubrir todo el recorrido:

h=288=3.5→4h=\cfrac{28}{8}=3.5 \rightarrow 4

De este modo, debemos construir 8 intervalos de amplitud 4cm, por lo que los intervalos cubren en total 32cm. Como el recorrido real es de 28cm, añadiremos 2cm por debajo del valor mínimo y 2cm por encima del valor máximo, de modo que los intervalos comenzarán en 156-2=154cm y terminarán en 184+2=186cm. Así pues, los intervalos serán: 154-158, 158-162, 162-166, 166-170, 170-174, 174-178, 178-182, 182-186. No nos queda más que realizar el conteo de datos para cada intervalo para obtener las frecuencias de clase que serán las alturas de las barras del histograma:

Interactivo Las 100 alturas de la tabla anterior, agrupadas con el procedimiento del texto: cada cuadrado es una chica. Con la regla de Sturges salen 8 intervalos de 4 cm, de 154 a 186. Mueve el deslizador para ver qué pasa con menos o más intervalos, y pasa por una barra para ver en la tabla qué datos la forman.

Diagrama de sectores (gráfico circular) – Diagrama de barras (gráfico de columnas) – Polígono de frecuencias – Ojiva (estadística)

Capítulo 12 de 17

Medidas de tendencia central

Matemática y estadística 720 palabras artículo suelto ↗
Interactivo Los datos 1, 1, 1, 2, 2, 3, 3, 5, 9: la moda es 1 (el valor que más se repite), la mediana 2 (el valor central) y la media 3 (27/9), que es el punto de apoyo donde la barra quedaría en equilibrio. Arrastra cualquier punto; con «Entra un millonario» se añade un dato extremo y solo la media lo nota.

Las medidas de tendencia central o medidas de centralización son valores que resumen un conjunto de datos cuantitativos indicando dónde se concentra la distribución: un solo número que habla en nombre de muchos. Para los datos 3, 4, 4, 5, 5, 5, 6, 6, 7, cualquiera diría que el conjunto «gira en torno al 5», y las tres medidas clásicas —media aritmética, mediana y moda— coinciden allí. Sin embargo, generalmente estas tres medidas del centro no coinciden, ya que no existe «el» centro como concepto único: existen al menos tres centros distintos que responden a preguntas distintas. La media aritmética es un promedio de todos los datos, la mediana el valor que deja debajo suyo la mitad de los datos y la otra mitad por encima y la moda el valor que más se repite. Existen además un buen número de medidas de tendencia central adicionales.

En relación a las tres medidas de tendencia central clásicas ya citadas, el caso documentado por excelencia es la renta. Las distribuciones de ingresos son asimétricas en prácticamente todos los países: la mayoría de la población se concentra en la mitad baja de la escala y una cola larguísima de rentas altas estira la distribución hacia la derecha. La Oficina del Censo de Estados Unidos publica ambas cifras cada año: la mediana del ingreso de los hogares para 2023 se situó en unos 80.600 dólares, mientras la media superaba los 114.000, es decir, un 40 % por encima. La diferencia no es un error: es el número exacto de cuánto influye la cola alta. Cuando un titular dice «la familia estadounidense media gana…», la palabra decisiva es cuál de los dos centros usa; con rentas, la mediana describe al hogar típico y la media describe al hogar típico más la influencia de los muy ricos dividida entre todos. Las estadísticas oficiales europeas, por cierto, casi siempre informan la mediana precisamente por esto.

De este modo, que un solo número pueda resumir mal no es un detalle: es una propiedad matemática demostrable. Por eso la pregunta correcta nunca es «¿cuál es la medida de tendencia central?» sino «¿qué pregunta debe responder ese número?»: la misma distribución de salarios responde cosas distintas si el lector es un sindicalista —que le importa el salario mediano que deja la mitad por debajo—, una empresa que fija precios —que quizá le importa la media del gasto— o un epidemiólogo —que puede necesitar la moda del comportamiento—.

De ahí las propiedades que sí conviene exigirle a un centro. La más discutida es la robustez: la media usa el valor de cada dato, así que un solo valor extremo la arrastra —si en el barrio entra un millonario, la media de la riqueza del bar salta, y la mediana no se mueve—; la mediana solo usa el orden, y la moda solo las repeticiones, lo que las vuelve inmunes a extremos a costa de desperdiciar información. Por eso existen los promedios intermedios: la media ponderada asigna pesos distintos a cada dato; la media geométrica es la correcta para variaciones porcentuales sucesivas, porque un aumento del 10 % seguido de una caída del 10 % no deja el valor inicial, y la media aritmética del 10 % y el −10 % oculta esa asimetría mientras la geométrica la revela; la media cuadrática subyace a la dispersión; y las medias recortadas, que descartan un porcentaje fijo en cada extremo antes de promediar, fueron popularizadas por Tukey precisamente para obtener un centro robusto que no renunciara del todo a las magnitudes. Todas son casos particulares de una idea más general: un «promedio» es un punto que minimiza una cierta distancia a los datos, la media con el cuadrado de las desviaciones, la mediana con el valor absoluto, y esa familia entera se formalizó en el siglo XX bajo el nombre de estimadores de localización.

Una regla de decisión sobre qué medida escoger es la siguiente: para datos simétricos sin valores atípicos, la media, por sus ventajas algebraicas; para datos asimétricos —rentas, precios de vivienda, tiempos de espera—, la mediana; y para datos cualitativos, solo la moda. Y en cualquier caso, mirar el gráfico (histograma, diagrama de barras, …) antes que el número.

Media aritmética simple – Mediana estadística – Moda estadística – Medidas de dispersión estadística – Medias recortadas (medias truncadas) – Medidas de asimetría estadística

Capítulo 13 de 17

Mediana estadística

Matemática y estadística 602 palabras artículo suelto ↗
Interactivo Cuatrocientos hogares simulados con una renta asimétrica. La mediana deja el 50 % de los hogares a cada lado; la media se va detrás de la cola. El deslizador alarga la cola derecha, el botón «Como EE. UU. 2023» la ajusta a la brecha del 40 % entre media y mediana, y el último añade un único hogar de 5 millones.

La mediana es el valor que ocupa la posición central de un conjunto de datos ordenados: deja la mitad de las observaciones a cada lado. Frente a la media aritmética, que promedia las magnitudes, la mediana solo mira el orden. Paradójicamente, ese desperdicio deliberado de información —ignorar cuánto vale cada dato, quedarse solo con dónde se sitúa— la hace más fiable que la media en la mayoría de las distribuciones reales, que son asimétricas y están llenas de extremos. Como medida de tendencia central, la mediana gana exactamente donde la media pierde.

El cálculo es elemental y conviene recordarlo con el procedimiento, no solo con el resultado. Primero se ordenan los datos de menor a mayor; después se toma el valor central. Con número impar, existe uno: las calificaciones 5, 7, 8, 5, 6, 9, 1 ordenadas son 1, 5, 5, 6, 7, 8, 9, y la mediana es 6, el cuarto valor. Con número par no hay valor central único, y la convención es promediar los dos del medio: para 1, 3, 5, 6, 7, 8, 9, 9, los centrales son 6 y 7, y la mediana es 6,5, la media de ambos. Con datos agrupados en intervalos el procedimiento interpola dentro de la clase mediana; el cálculo paso a paso está en Mediana para datos agrupados.

Frente a la media aritmética, la mediana no es una mera alternativa técnica sino la elección institucional. Eurostat publica como indicador estándar de vida la mediana de la renta disponible equivalente de los hogares, no la media; la Oficina del Censo de Estados Unidos hace lo propio con la mediana del ingreso familiar. La razón es cuantificable: en 2023 la mediana del ingreso de los hogares estadounidenses fue de unos 80.600 dólares y la media superaba los 114.000, un 40 % más. Ese 40 % no es dispersión: es la suma de la influencia de los hogares muy ricos repartida entre todos. La OCDE publica sus salarios en mediana precisamente por eso, y las comparaciones internacionales de niveles de vida se hacen con rentas medianas equivalentes, no con medias. Cuando se dice «la familia típica», la mediana la describe y la media no; por eso un país puede tener una media de ingresos creciente y una mediana estancada a la vez, y ese desacoplamiento es en sí mismo un dato político. El mismo argumento aplica a precios de vivienda, patrimonio y tiempos de espera sanitarios: en cuanto la distribución tiene cola larga, el centro robusto es el informativo.

Aún así, la mediana no es algebraicamente cómoda: la mediana de una suma no es la suma de las medianas, la de los promedios no es el promedio de las medianas, y esa fragilidad matemática hace que muchos aparatos inferenciales —mínimos cuadrados, análisis de varianza— trabajen con medias aunque describan peor. Y hay un coste estadístico: para distribuciones normales, la media extrae más información de cada dato y su error estándar es menor —aproximadamente un 25 % mayor para la mediana—, de modo que usar la mediana allí es tirar precisión a cambio de robustez que no se necesita.

La síntesis práctica no puede ser más simple. Distribución aproximadamente simétrica y sin valores atípicos: la media, más eficiente. Distribución asimétrica, datos ordinales, o sospecha de extremos: la mediana, más honesta. Y si no se sabe cuál es la forma de la distribución, la respuesta correcta no es elegir a ciegas: es mirarla antes de resumirla, porque la mediana y la media se separan exactamente cuando la distribución tiene algo que contar.

Mediana para datos agrupados (cálculo) – Clase mediana – Media aritmética simple – Medidas de tendencia central – Estadísticos robustos

Capítulo 14 de 17

Moda estadística

Matemática y estadística 383 palabras artículo suelto ↗

ikusmira-media_mediana_moda-1.png

La moda es el valor que más veces se repite en un grupo de datos. En la imagen, media, mediana y moda, las tres medidas de tendencia central más utilizadas, para un grupo de 9 datos. La moda es 1 porque se repite 3 veces, más que ningún otro valor.

En estadística, la moda es el valor de variable que aparece con mayor frecuencia en un grupo de datos. La moda también se define para distribuciones de probabilidad, como el valor de variable aleatoria que presenta una mayor probabilidad, en el caso de distribuciones discretas, o mayor densidad de probabilidad, en el caso de distribuciones continuas. Junto con la media aritmética simple y la mediana, la moda es una de las medidas de tendencia central más utilizadas, mostrando como aquellas el centro de la distribución de datos. Puede determinarse para distribuciones de variables cuantitativas como cualitativas. Además, la comparación de la moda con la media y la mediana, para una variable cuantitativa, nos da una idea  de la asimetría de la distribución; por ejemplo, como ocurre en la distribución normal, la igualdad entre media, mediana y moda indica que la distribución es perfectamente simétrica.

Sin embargo, la definición anterior presenta como inconveniente que la moda puede tomar más de un valor, cuando la mayor frecuencia o probabilidad es común a un grupo de valores, y de esta forma deben distinguirse distribuciones unimodales, es decir, con una única moda, distribuciones bimodales, con dos modas, e incluso distribuciones con tres o más modas. La existencia de varias modas en una distribución es un indicio de heterogeneidad, es decir, de que los datos provienen de diferentes poblaciones.

Cuando los datos provienen de una variable continua, lo más común es que todos los datos sean diferentes, de modo que todos se repiten una vez, quedando de esta forma la moda sin definir; en este caso, lo más adecuado es agrupar los datos en intervalos y tomar como moda un valor de la variable perteneciente a clase modal o intervalo de mayor frecuencia (consulta en Ikusmira: Cálculo de la moda para datos agrupados en intervalos). Alternativamente se puede estimar una curva de densidad a partir de los datos y tomar como estimación de la moda el valor con mayor densidad. Cuando nos referimos a distribuciones de probabilidad, la moda puede no existir, como ocurre en el caso de la distribución uniforme continua, dado que en esta todos los valores de un intervalo tienen la misma probabilidad de ocurrencia.

Moda absoluta y moda relativa – Distribución bimodal – Distribución multimodal – Coeficiente de asimetría de Pearson – Datos agrupados

Capítulo 15 de 17

Medidas de dispersión estadística

Matemática y estadística 273 palabras artículo suelto ↗

La dispersión o variabilidad es la característica de las variables estadísticas cuantitativas unidimensionales que se refiere a la distancia que existe entre los datos (por ejemplo, el recorrido y el recorrido intercuartílico, entre otras) o la distancia entre estos y el centro de la distribución (desviación media absoluta, desviación típica, varianza, entre otros). En una palabra, la dispersión mide la variabilidad de un conjunto de datos. Cuanto mayor es esta distancia, mayor es la dispersión. Tras la tendencia central, la dispersión es la característica de las distribuciones estadísticas más importante; de hecho suele decirse que una medida de centralización significa poca cosa si no va acompañada de una medida de variabilidad o dispersión, en el sentido de que una mayor dispersión de la variable hace menos significativa la medida de tendencia central, ya que indicaría que los datos no se agrupan a poca distancia del centro.

Por otra parte, dentro de las medidas o parámetros de dispersión debe distinguirse entre medidas de variabilidad o dispersión absoluta, que simplemente miden la distancia absoluta respecto del centro de la distribución, y medidas de dispersión relativa, que miden esta distancia relativamente al valor del centro de la distribución. Para comparar la dispersión de diferentes distribuciones, debe utilizarse generalmente una medida de dispersión relativa.

Medidas de dispersión absoluta

Medidas de dispersión relativa

Medidas de tendencia central – Medidas de asimetría estadística – Curtosis (estadística) – Medidas de concentración (estadística)

Capítulo 16 de 17

Varianza

Matemática y estadística 344 palabras artículo suelto ↗

La varianza es una medida de dispersión que cuantifica la variabilidad de un conjunto de datos alrededor de su media aritmética. Se define como el promedio de los cuadrados de las desviaciones de cada dato respecto a la media. Es una de las medidas de dispersión más fundamentales y utilizadas en estadística descriptiva e inferencial, proporcionando una idea de cuán dispersos o concentrados están los valores en una distribución. Un valor de varianza alto indica que los datos están muy dispersos, mientras que un valor bajo sugiere que están agrupados cerca de la media.

Para una población completa, la varianza se denota con la letra griega sigma al cuadrado (σ2\sigma^2). Su fórmula se expresa como σ2=∑i=1N(xi−μ)2N\sigma^2 = \frac{\sum_{i=1}^{N} (x_i - \mu)^2}{N}, donde xix_i representa cada valor individual en la población, μ\mu es la media poblacional y NN es el tamaño total de la población. Cuando se trabaja con una muestra de datos extraída de una población, la varianza muestral se denota como s2s^2. Para obtener una estimación insesgada de la varianza poblacional a partir de una muestra, se aplica la corrección de Bessel, dividiendo la suma de los cuadrados de las desviaciones por n−1n-1 (donde nn es el tamaño de la muestra) en lugar de nn. Así, la fórmula para la varianza muestral es s2=∑i=1n(xi−xˉ)2n−1s^2 = \frac{\sum_{i=1}^{n} (x_i - \bar{x})^2}{n-1}, siendo xˉ\bar{x} la media muestral.

Una característica importante de la varianza es que sus unidades de medida son el cuadrado de las unidades originales de los datos. Por ejemplo, si los datos se miden en kilogramos, la varianza se expresará en kilogramos cuadrados. Esta propiedad hace que la varianza sea a menudo menos intuitiva de interpretar directamente en el contexto original de los datos. Por esta razón, se recurre frecuentemente a la desviación típica (o estándar), que es la raíz cuadrada positiva de la varianza (σ=σ2\sigma = \sqrt{\sigma^2} para la población y s=s2s = \sqrt{s^2} para la muestra). La desviación típica devuelve la medida de dispersión a las unidades originales, facilitando una comprensión más directa de la magnitud de la dispersión de los datos.

Varianza poblacional – Corrección de Bessel – Medidas de dispersión estadística – Desviación típica (desviación estándar) – Error típico (error estándar)

Capítulo 17 de 17

Desviación típica (desviación estándar)

Matemática y estadística 965 palabras artículo suelto ↗

La desviación típica o desviación estándar es una medida de dispersión absoluta que mide la media de desviación de cada valor de la variable estadística respecto a la media aritmética simple, en el caso de datos cuantitativos, o esperanza matemática, en el caso de una variable aleatoria. Es la medida de dispersión  más utilizada en la práctica, y en muchos modelos estadísticos es un parámetro básico que define la distribución, por ejemplo en la distribución normal. Asimismo, es un dato fundamental en un gran número de métodos estadísticos. Puede calcularse para distribuciones de datos como para distribuciones de probabilidad. La desviación típica elevada al cuadrado es la varianza. Su valor siempre es positivo o 0, cuanto mayor es su valor la dispersión se considera que es mayor, aunque no existe un valor a partir del cual pueda afirmarse que la dispersión es grande o pequeña, al ser una característica relativa,. Por otra parte, la desviación típica viene dada en las misma unidad de la variable a la que se refiere; por ejemplo, si los datos viene dados en metros, el resultado de la desviación típica vendrá también dado en metros.

Desviación típica para distribuciones de datos

Para una serie de datos x1,x2,...,xnx_1,x_2,...,x_n la desviación típica, representada por sxs_x se calcula de acuerdo a la siguiente fórmula:

sx=∑(xi−x‾)2n=∑xi2n−x‾2s_x=\sqrt{\cfrac{\sum(x_i-\overline{x})^2}{n}}=\sqrt{\cfrac{\sum x_i^2}{n}-\overline{x}^2}

En la fórmula anterior aparecen dos expresiones equivalentes, que proporcionan el mismo resultado: la primera corresponde a la fórmula original de la desviación típica, como media cuadrática de las desviaciones de cada dato respecto a la media; desarrollando esa expresión se llega a la segunda versión de la fórmula que permite el cálculo de la desviación típica de forma más simple y rápida.

Ejemplo

Las calificaciones de un grupo de alumnos en una asginatura son las siguientes: 1-3-5-7 (puntos). Para calcular la desviación típica según la fórmula original el primer paso es siempre calcular la media aritmética simple, para lo cual hay sumar los datos (columna 1):

x‾=∑xin=205=4\overline{x}=\cfrac{\sum x_i}{n}=\cfrac{20}{5}=4

 A continuación hay que calcular las desviaciones de cada dato a la media, cuya suma siempre es 0 (columna 2) ya que se compensan las desviaciones negativas con las positivas. Para evitar esto, calculamos la media cuadrática de dichas desviaciones, es decir, la desviación típica, tomando para ello la suma de las desviaciones al cuadrado (columna 3):

xix_i
(xi−x‾)(x_i-\overline{x})
(xi−x‾)2(x_i-\overline{x})^2
1-39
3-11
51
1
739
400
Suma=20
Suma=0
Suma=20
sx=(xi−x‾)2n=205=2pt. s_x=\sqrt{\cfrac{(x_i-\overline{x})^2}{n}}=\sqrt{\cfrac{20}{5}}=2pt.

Es decir, cada alumno se desvía en promedio de la media aritmética simple 2 puntos.

El cálculo a través de la segunda versión de la fórmula es más rápido:

xix_i
xi2x_i^2
11
39
525
749
416
Suma=20
Suma=100
sx=∑xi2n−x‾2=1005−42=2pt.s_x=\sqrt{\cfrac{\sum x_i^2}{n}-\overline{x}^2}=\cfrac{100}{5}-4^2=2pt.

Puntuación estándar (puntuación tipificada, valor z) – Error típico (error estándar) – Varianza muestral – Coeficiente de asimetría de Fisher – Frecuencia acumulada

Este itinerario ordena artículos de la enciclopedia; cada uno vive también suelto, con sus fuentes y su historial. ¿Le falta un capítulo o le sobra uno? Dínoslo.

Todos los itinerarios →